ArticleInfrastructure & Cloud
ZeroPoint ambitionne de mieux gérer la mémoire des serveurs
Alors que la demande en puissance de calcul augmente avec l'essor de l'intelligence artificielle, la start-up suédoise ZeroPoint Technologies propose de mieux gérer la mémoire (cache, RAM, CXL et NVMe) installée dans les serveurs avec ses algorithmes de compression et de gestion des priorités.

Fondé en 2016 à Gothenburg, en Suède, par Per Stenström (CSO) et Angelos Arelakis (CTO), ZeroPoint Technologies vient s’attaquer à un des goulets d’étranglement dans les datacenters, à savoir la gestion de la mémoire (cache, RAM, CXL et NvMe) disponible pour les traitements. Lors d’un récent IT Press Tour à Istanbul, Klas Moreau, CEO de ZepoPoint, nous a expliqué comment la start-up entendait percer sur le marché des serveurs avec une compression mémoire matériellement qui peut, selon leurs études, réduire le coût total de possession (TCO) des serveurs de 20 à 25 %, tout en augmentant la performance énergétique de 50 %. Cette technologie permet de compacter et gérer la mémoire de façon plus efficace, évitant ainsi l'achat de barrettes mémoire supplémentaire. Une équation intéressante, quand on rappelle qu’un Dell PowerEdge R760 avec une puce Xeon Platinium 8468 (56 cœurs) plafonne à 4 To de RAM (16 Dimm par processeur) en mono-socket et 8 To en bi-socket pour un tarif avoisinant les 300 à 600 000 € pour la seule partie mémoire vive.
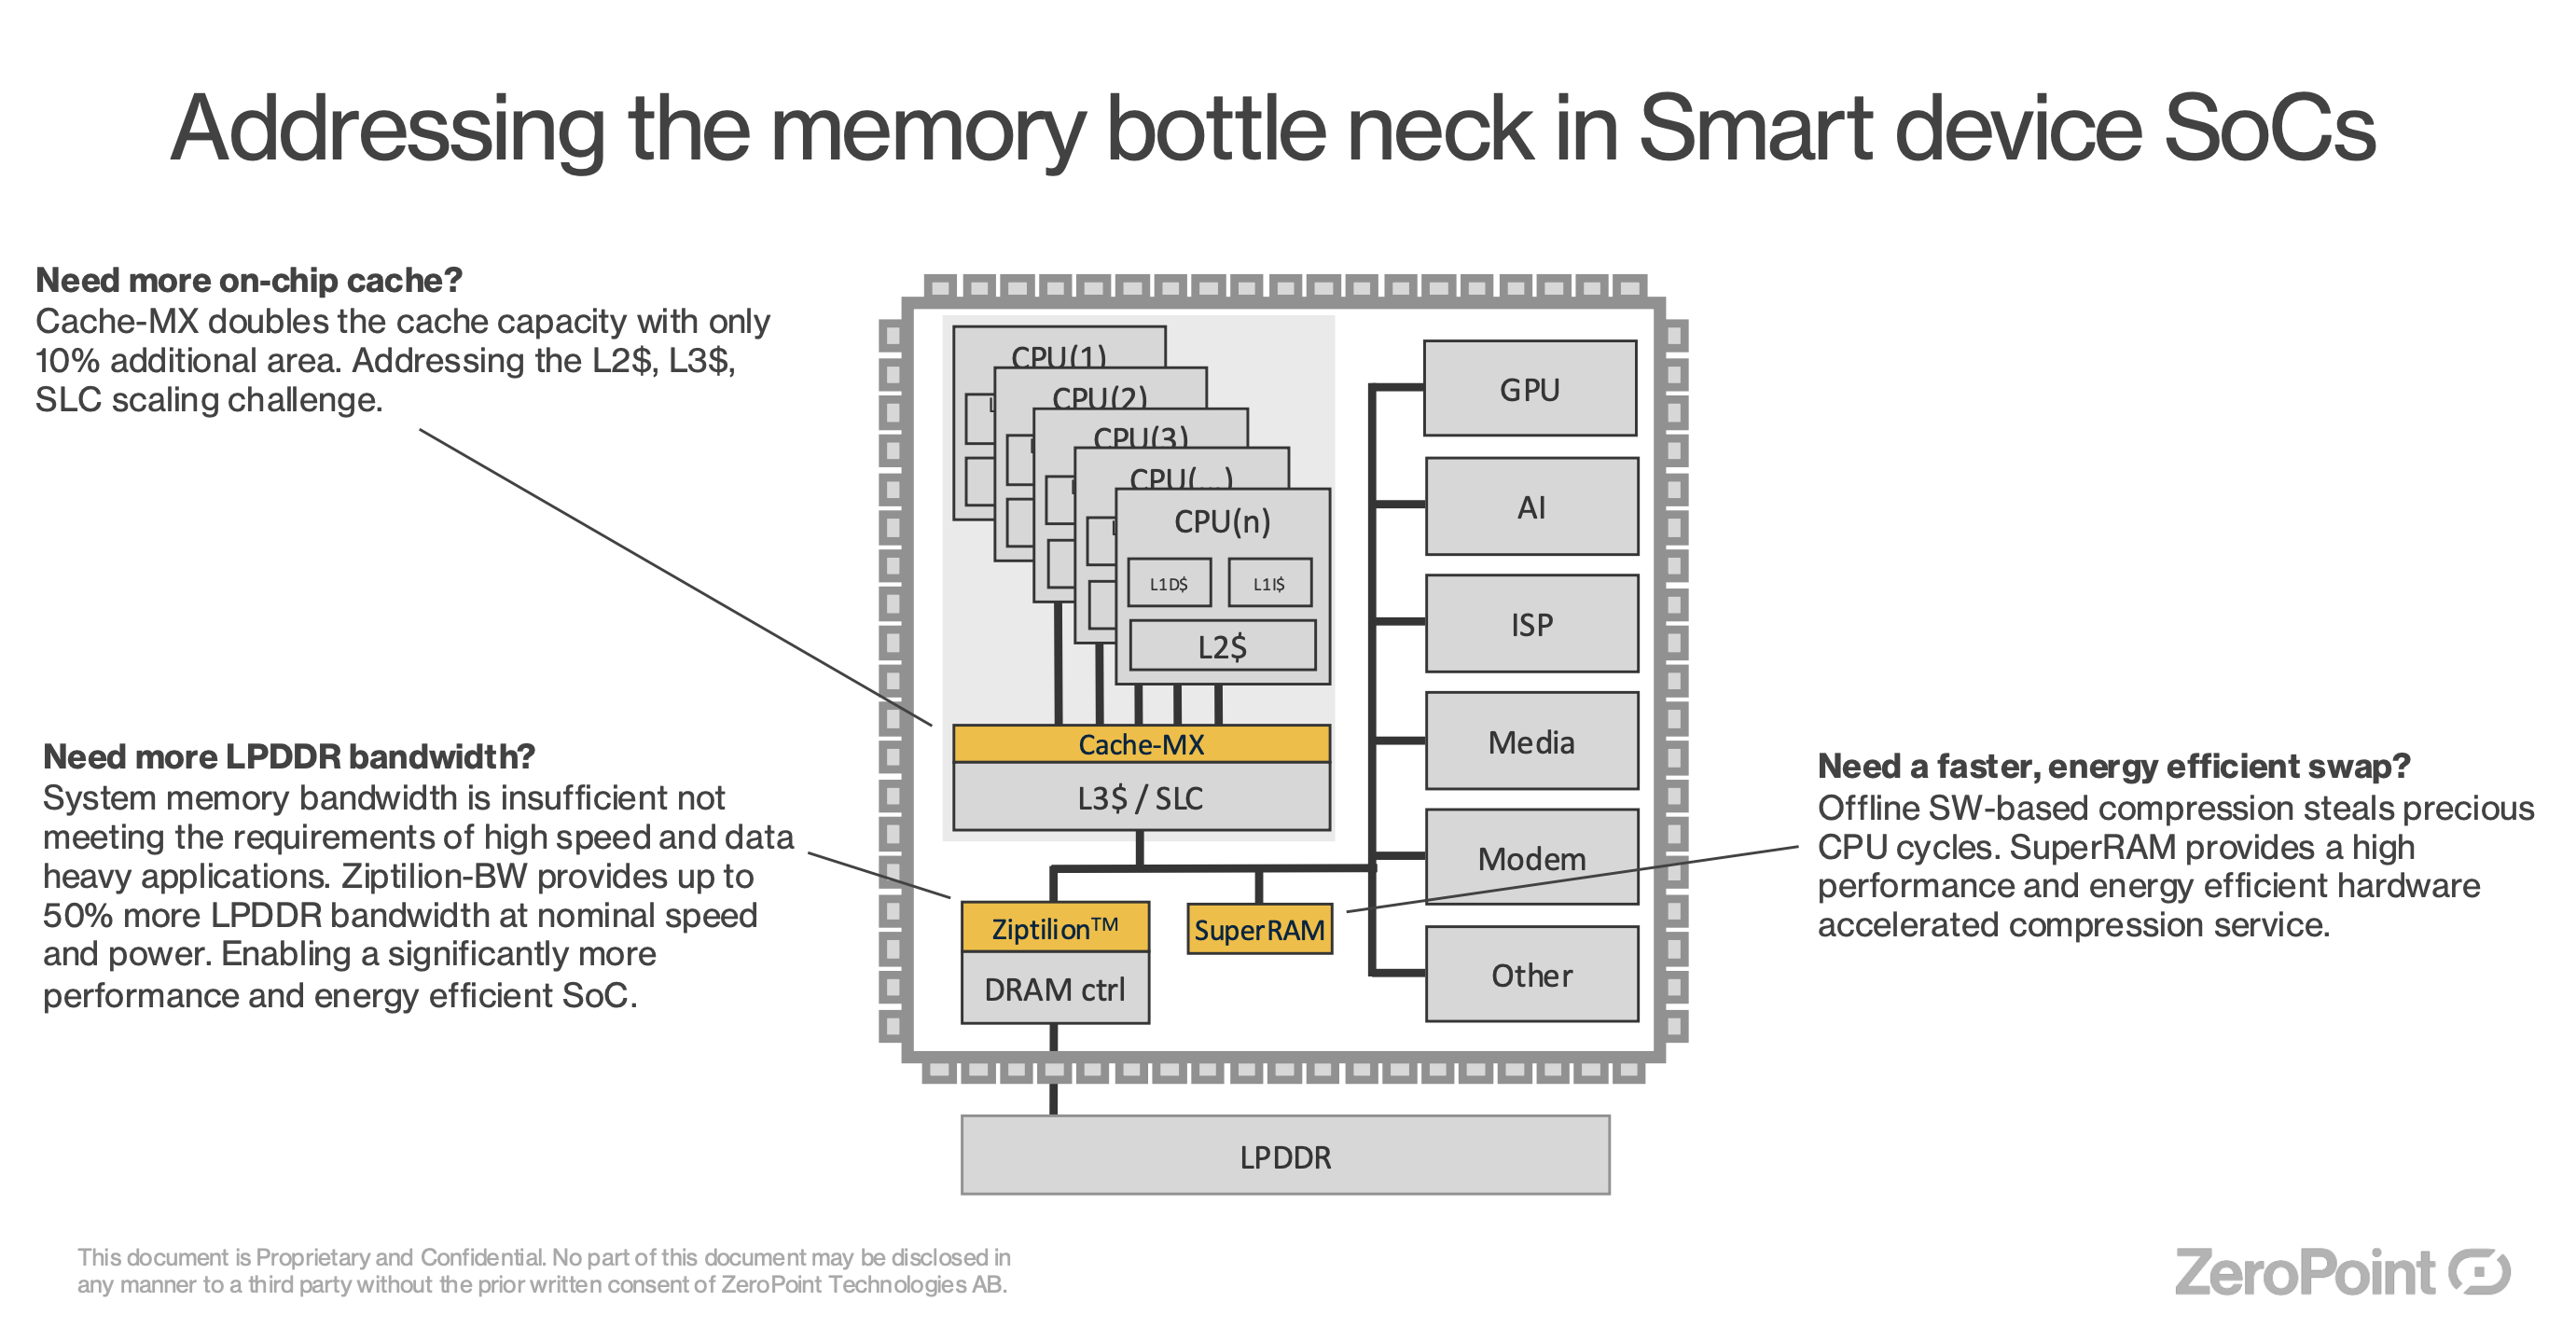
ZeroPoint affirme que Cache-MX offrira une amélioration de 25 % des performances de l'unité centrale par watt, tout en utilisant la moitié de la quantité de SRAM et en consommant la même quantité d'énergie.
Les algorithmes de compression développés par ZeroPoint (Cache-MX pour le cache, SuperRAM et Ziptilion pour la mémoire vive) sont à la fois rapides et sans perte : toutes les données pertinentes sont conservées tandis que les redondances sont éliminées. Les algorithmes de ZeroPoint permettent une compression à la volée des insertions de lignes de cache et une décompression à la volée des données lues/écrites. Le résultat est que chaque mégaoctet physique de SRAM est maintenant perçu par le système comme étant de deux mégaoctets. Les algorithmes assurent un taux de compression de plus de 2 avec les benchmarks SPEC2017FP et Renaissance,de 2,5 pour MLPerf/Training et de 2,5 pour MonetDB+TPC-H. Il y a bien sûr une pénalité au niveau de la latence, qui peut aller jusqu'à 8 cycles pour la compression/décompression, plus un cycle supplémentaire pour la balise mémoire, dans un système fonctionnant à 1,6 GHz.
Une compression accélérée
Fonctionnant en temps réel, ces algorithmes sont intégrés dans l'architecture des serveurs, au niveau du processeur et de la carte mère. Il ne s’agit pas d’un ajout au noyau de Linux comme le propose Meta avec son code TMO (Transparent Memory Offloading ou déchargement transparent de la mémoire). Ce dernier est intégré au noyau Linux pour analyser en temps réel la mémoire et les I/O et mesurer la perte de traitement en raison d’un manque de ressources au niveau du CPU. Guidé par ces résultats, le TMO ajuste automatiquement la quantité de mémoire à décharger sur d’autres ressources comme la compression mémoire ou les SSD (architecture in-memory).
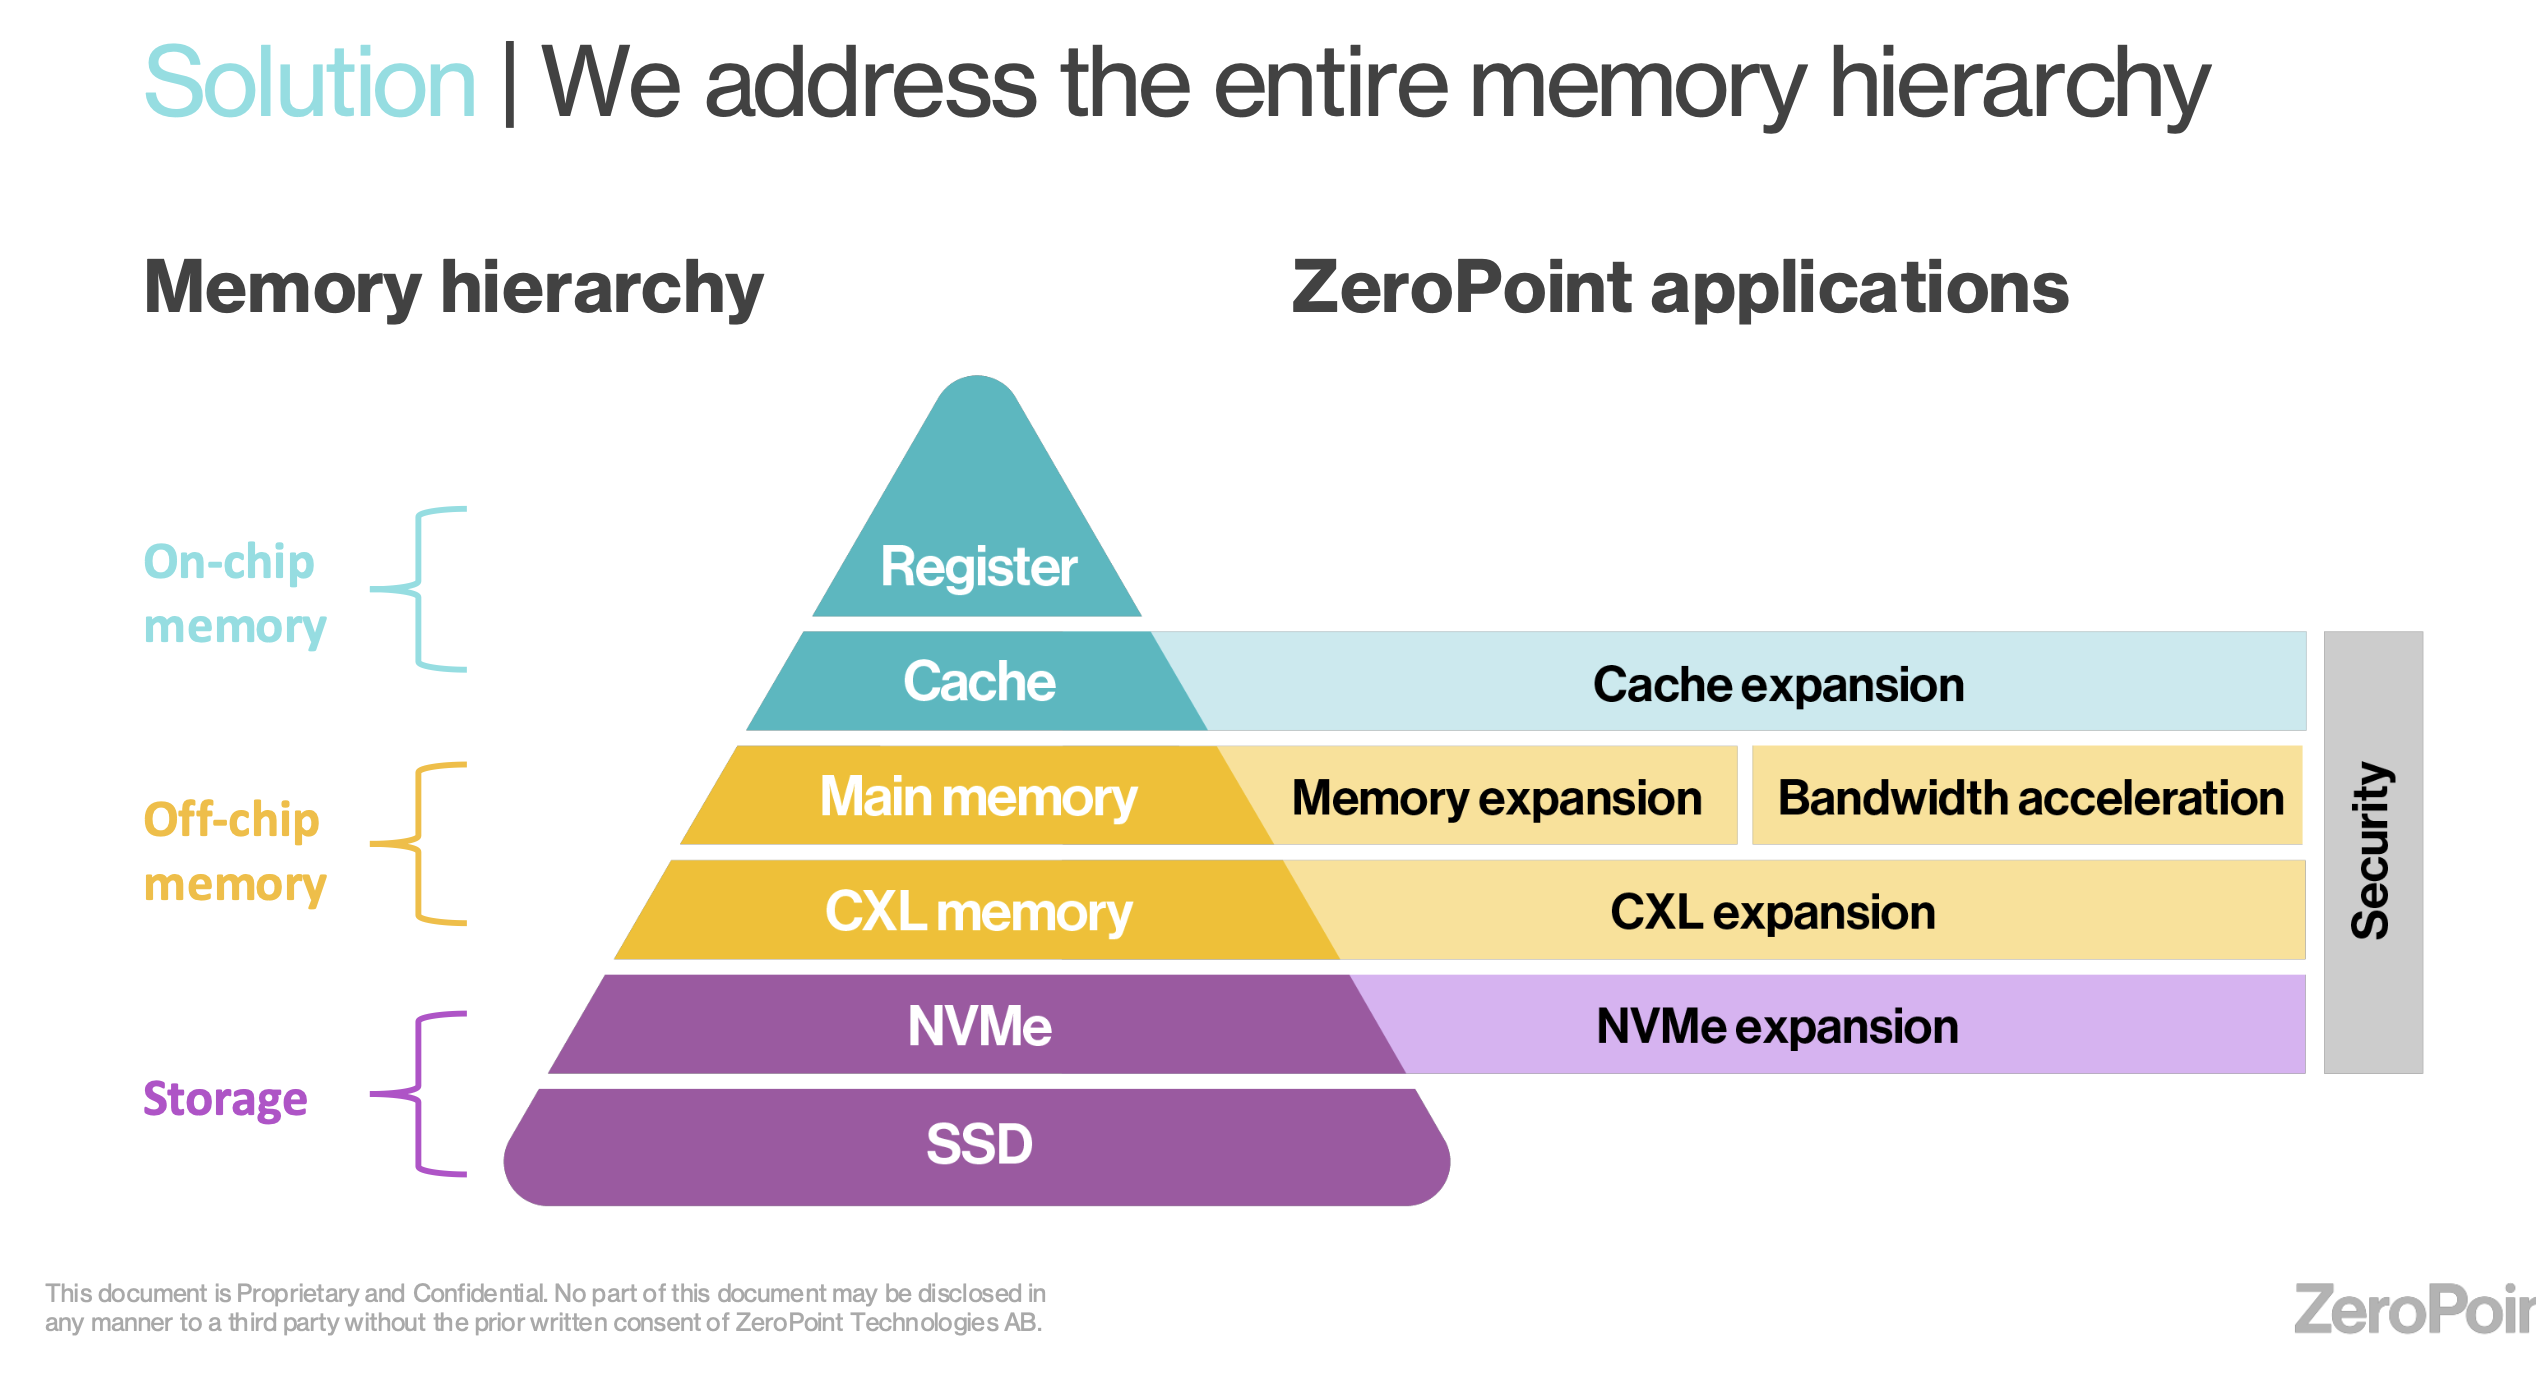
ZeroPoint s’adapte à différents types de processeurs et d’architectures, à savoir x86, Arm et Risc-V.
Si la compression mémoire accélérée par matériel de ZeroPoint est – selon la start-up - capable de multiplier par quatre la capacité des serveurs tout en réduisant drastiquement leur empreinte carbone, son intégration demande une collaboration étroite avec les fabricants de puces et de cartes mères. Une tâche pour le moins ardue. L'architecture de ZeroPoint nécessite l'ajout d'un bloc IP au contrôleur de cache de dernier niveau, c’est-à-dire dans le silicium du processeur. Cette technologie peut travailler avec les plateformes x86, Arm, et Risc-V, mais ZeroPoint ne vend pas d’accélérateur à installer sur une carte mère ou à greffer au sein d’une architecture SoC. La start-up, qui a pour l’instant testé sur sa technologie sur un FPGA et une puce gravée en 5 nm chez TSMC, propose des licences logicielles aux fournisseurs de puces et des contacts ont été pris avec les principaux acteurs du marché.