
ArticleApplications & Développement
Les LLM vulnérables à des attaques par paquets compromis
D'après la première étude importante sur l'hallucination de paquets, les LLM pourraient être exploités pour lancer des vagues d'attaques par « confusion de paquets ».
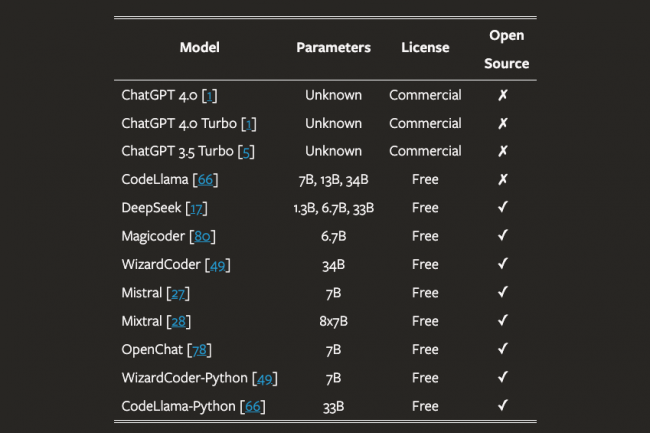
Dans l'une des études les plus étendues et les plus approfondies jamais réalisées sur le sujet, des chercheurs universitaire (Université de San Antonio au Texas, Université de Virginie et Université de l’Oklahoma) ont découvert que les grands modèles de langage (LLM) présentaient un sérieux problème d'hallucination de paquets que des attaquants pourraient exploiter pour introduire des paquets codés malveillants dans la chaîne d'approvisionnement. Le problème est tellement grave qu'au cours de 30 tests différents, les chercheurs ont constaté que 440 445 (19,7 %) des 2,23 millions d'échantillons de code qu'ils ont générés expérimentalement dans deux des langages de programmation les plus populaires, Python et JavaScript, en utilisant 16 modèles LLM différents pour Python et 14 modèles pour JavaScript, contenaient des références à des paquets qui avaient été hallucinés.
L'étude multi-universitaire, publiée pour la première fois en juin, mais récemment mise à jour, a également généré « un nombre stupéfiant de 205 474 exemples uniques de noms de paquets hallucinés, soulignant encore davantage la gravité et l'omniprésence de cette menace ». Le problème trouve son origine dans la popularité de nombreuses bibliothèques et paquets Python et JavaScript que les développeurs utilisent pour assembler rapidement des programmes à partir de multiples éléments plus petits. La présence de codes malveillants dans les référentiels de code n’est pas nouvelle. Les chercheurs rappellent qu'en 2023, une étude avait permis de découvrir 245 000 paquets malveillants dans les seuls référentiels de logiciels open source.
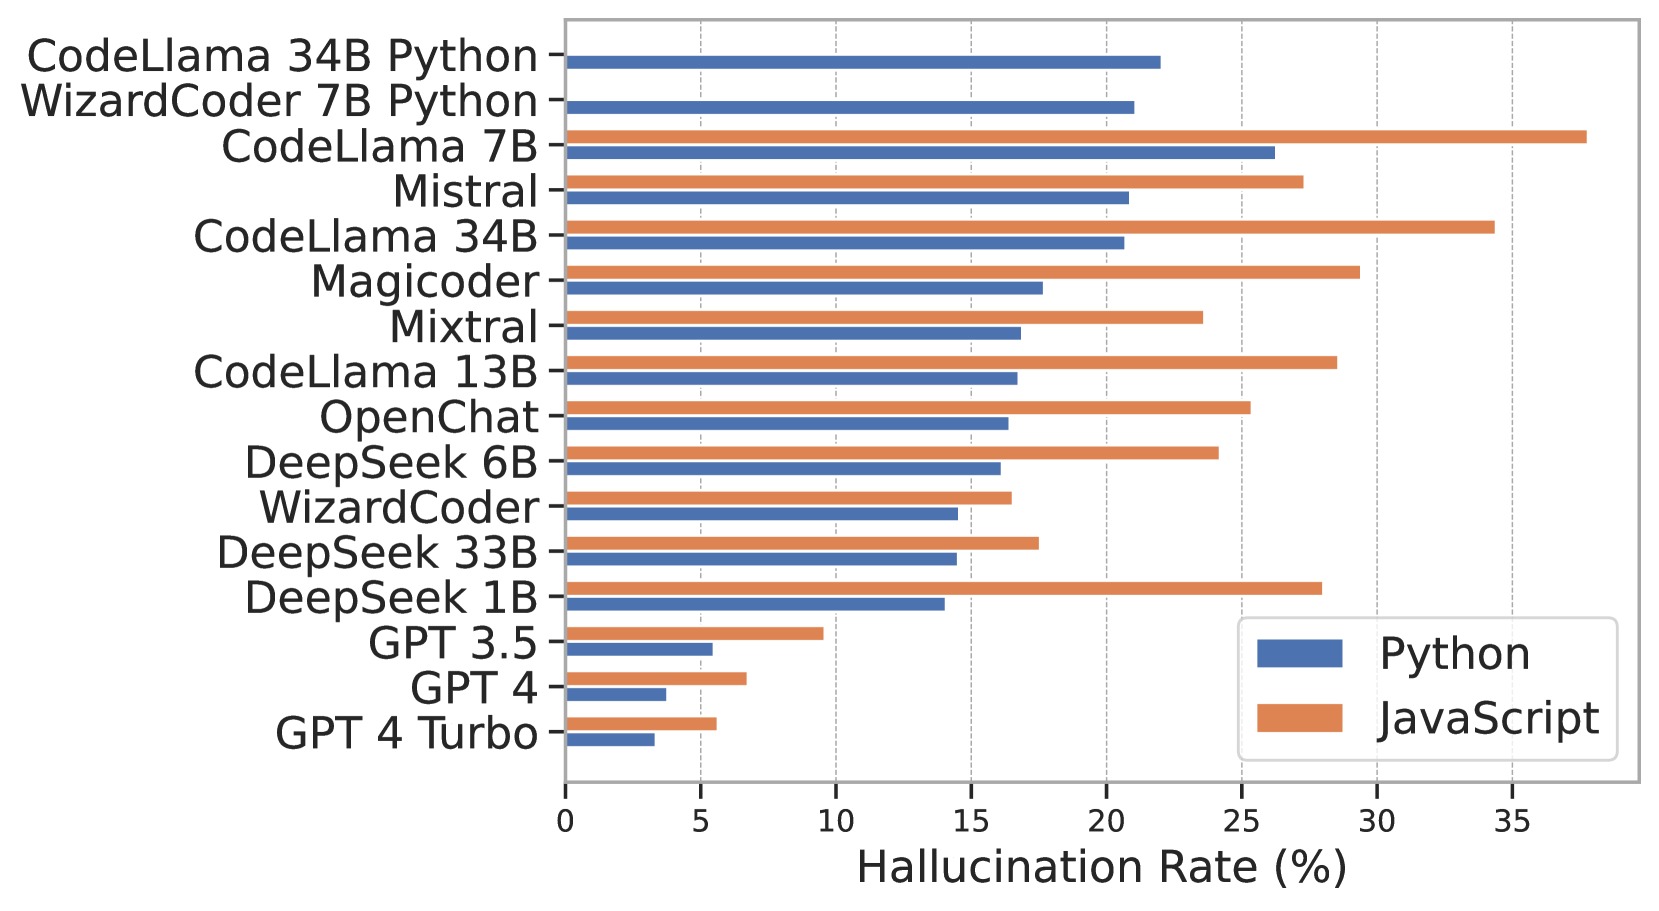
Les principaux LLM du marché ont été évalués par les chercheurs des trous universités américaines. (Crédit D.R.)
Le cauchemar de l'hallucination
Malheureusement, l'étude actuelle suggère que l'arrivée de l'IA, par le biais de « l’hallucination de paquets » dont sont affectés les LLM, ne fera qu'empirer les choses. On sait déjà que les LLM sont sujets à des hallucinations, c'est-à-dire qu’ils renvoient des réponses absurdes aux questions posées. Cela se produit aussi dans le processus de codage, quand le développeur reçoit une réponse absurde après avoir saisi une invite de codage dans le LLM. Dans le cas de l'hallucination de paquets, le LLM va plus loin et recommande ou génère du code incluant un paquet dans un référentiel logiciel qui n'existe pas. La logique voudrait que tout code qui s'y réfère devrait échouer. Mais il y a une deuxième possibilité : l'attaque dite par « confusion de paquets » dans laquelle les attaquants génèrent des paquets hallucinés avant de les ensemencer avec des logiciels malveillants.
L'étape suivante consisterait à inciter les développeurs à les télécharger pour qu'ils soient finalement inclus dans des programmes légitimes plus importants. Ils pourraient même rendre le code légitime au départ, afin d'accroître la confiance avant de libérer une charge utile plus tard. « Les utilisateurs peu méfiants, qui font confiance au résultat du LLM, ne se donneront pas la peine de vérifier la validité de ces paquets hallucinés dans le code généré et pourraient inclure par inadvertance ces paquets malveillants dans leur base de code », ont expliqué les chercheurs. « Le code open-source non sécurisé qui en résulte peut aussi être inclus dans la chaîne de dépendance d'autres paquets et codes, entraînant un effet de cascade et la propagation des vulnérabilités à travers de nombreuses bases de code ».
Sésame ouvert
Si aucun des LLM testés par les chercheurs n’est sorti indemne, certains étaient nettement moins bons que d'autres. « Les modèles de la série GPT étaient quatre fois moins susceptibles de générer des paquets hallucinés que les modèles open-source, avec un taux d'hallucination de 5,2 % contre 21,7 % », ont fait remarquer les chercheurs. Toujours selon l'étude, le code Python était également moins sensible au phénomène que le code JavaScript. Les attaques par confusion de paquets sur les référentiels existent depuis des années et elles impliquent généralement le typosquatting (exploitation de la similarité des noms) ou le brandjacking (détournement de nom d’une marque). À cela s'ajoutent des attaques plus conventionnelles où des criminels téléchargent des paquets malveillants dans les référentiels, ou corrompent simplement des paquets légitimes.
Selon les chercheurs, l'hallucination pourrait renforcer ce phénomène. Au début de l'année 2024, le chercheur Bar Lanyado de Lasso Security a fait frémir une partie du monde des développeurs en découvrant que plusieurs grandes entreprises, dont le géant du commerce électronique Alibaba, utilisaient ou recommandaient un logiciel Python appelé « huggingface-cli ». Or ce paquet était complètement halluciné. Quand le chercheur a téléchargé un paquet vide portant le même nom dans un référentiel pour tester sa popularité, il a constaté qu’il avait été téléchargé plus de 30 000 fois en l'espace de trois mois. En d'autres termes, un grand nombre de développeurs téléchargeaient un progiciel imaginaire parce qu'un LLM avait, à un moment donné, halluciné son existence pour résoudre une tâche de programmation spécifique. Jusqu'à présent, aucune attaque par confusion de paquets n'a été détectée, mais le fait que cette possibilité soit désormais largement connue laisse penser qu'un incident réel finira par se produire à un moment ou à un autre.
Quelle solution ?
Les auteurs se sont interrogés sur les différentes solutions pouvant atténuer le problème de l'hallucination. L’une d’elles, qu'ils estiment inefficace, consiste à croiser les paquets générés avec une sorte de liste maîtresse. Si cette solution peut permettre de détecter les faux paquets, elle ne les empêcherait pas de devenir des menaces actives au même titre que d'autres menaces logicielles. Selon eux, une meilleure solution serait d'abord de s'attaquer à la question sous-jacente de la génération d’hallucinations par les LLM. Il faudrait pour cela une meilleure ingénierie de l'invite et utiliser la génération augmentée de récupération (Retrieval Augmented Generation, RAG) pour générer des réponses plus restreintes à partir d'ensembles de données spécialisés. De plus, les LLM eux-mêmes pourraient être affinés afin d'améliorer les résultats des tâches les plus susceptibles de générer des hallucinations. Pour aboutir à ces améliorations difficiles, une action des développeurs de LLM eux-mêmes est nécessaire. Mais tout reste à faire. « Nous avons divulgué nos recherches aux fournisseurs de modèles, notamment OpenAI, Meta, DeepSeek et Mistral AI, mais, à l'heure où nous écrivons ces lignes, nous n'avons reçu aucune réponse ni aucun commentaire de leur part », ont indiqué les auteurs dans une récente mise à jour de l'étude.


