
ArticleApplications & Développement
OpenMP : une alternative open source à Cuda pour le calcul parallèle
Interface de programmation pour le calcul parallèle sur les architectures à mémoire partagée, l'API OpenMP se pose comme un standard industriel pour concurrencer les solutions propriétaires de Nvidia dans le calcul haute performance et l'intelligence artificielle.

L'OpenMP Architecture Review Board (ARB) se positionne comme une alternative ouverte à des frameworks propriétaires comme Cuda dans l'écosystème du calcul parallèle. Consortium américain à but non lucratif, OpenMP standardise un modèle de programmation basé sur des directives compilateur pour simplifier le développement d'applications haute performance sur des architectures hétérogènes (CPU, GPU et FPGA). L'OpenMP ARB rassemble les principaux acteurs du calcul haute performance (AMD, Intel, IBM, Nvidia ou encore HPE) dans une structure à trois niveaux. Le Board of Directors assure la gouvernance réglementaire, les officiers dirigent les opérations stratégiques, tandis que le comité technique Language Committee développe la spécification. Cette association regroupe des laboratoires nationaux américains comme l’Argonne National Laboratory et le Los Alamos National Laboratory, des centres de recherche européens comme le BSC en Espagne et le CEA en France, ainsi que des constructeurs AMD, Intel, Nvidia et IBM. Curieusement, Dell n'apparaît pas parmi les membres du consortium OpenMP, contrairement à HPE qui dispose de sa propre suite d'outils de programmation parallèle. Cette absence s'explique par le positionnement de Dell comme assembleur OEM plutôt qu'un développeur de compilateurs et d'environnements logiciels.
Les caractéristiques techniques d'OpenMP 6.0
La version 6.0, publiée en novembre 2024, introduit des simplifications majeures pour la programmation basée sur les tâches et améliore le support des accélérateurs. Michael Klemm, CEO d'OpenMP et directeur technique chez AMD, explique : "Nous avons introduit des transformations de boucles simplifiées et un support d'induction [NDLR: Méthode de programmation], ainsi que la compatibilité avec les derniers standards C23/C++23 et Fortran 2023". La plateforme supporte une gamme étendue d'architectures incluant les processeurs Intel x86, Arm, AMD et IBM Power, ainsi que les accélérateurs GPU AMD et Nvidia et les FPGA. Cette approche multiarchitecture contraste avec les solutions propriétaires comme Cuda qui restent liées à une plateforme matérielle. Celle de Nvidia pour ne pas le citer.
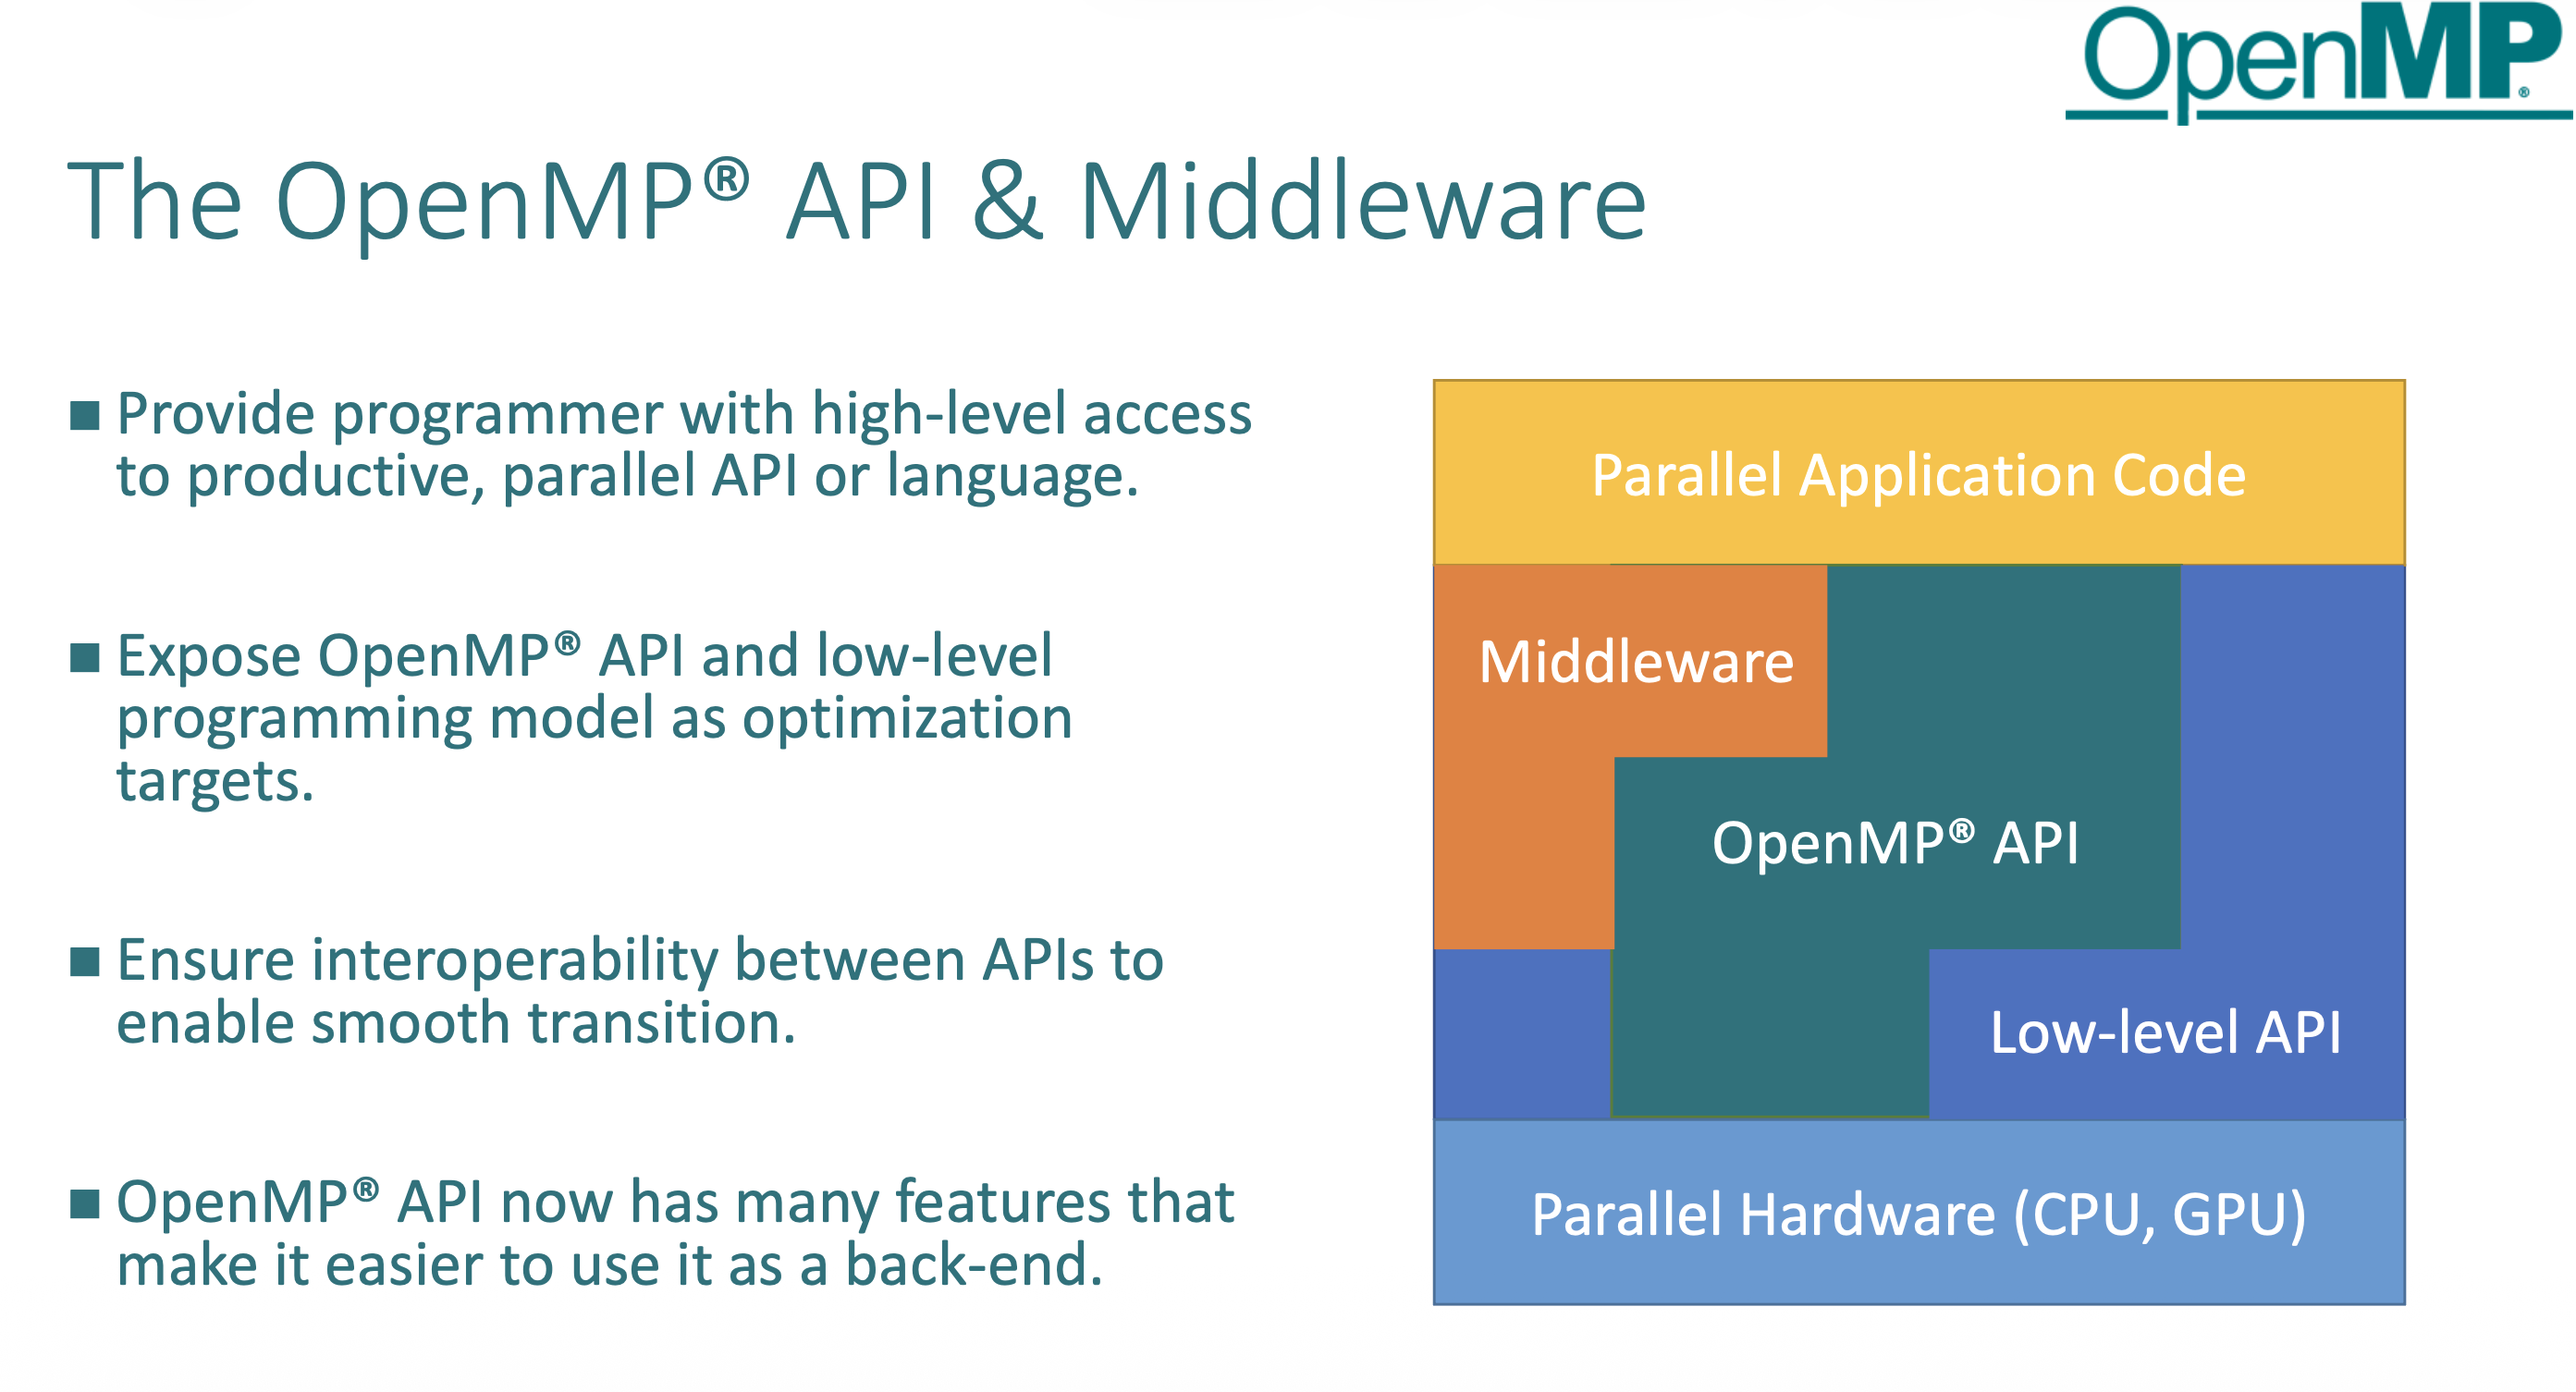
Compatible avec C, C++ et Fortran – en attendant un support de Python à venir - et pris en charge par la plupart des compilateurs modernes, OpenMP permet une programmation parallèle simple et portable sur des systèmes à mémoire partagée.
Stratégie concurrentielle face à Cuda et aux alternatives
Face à la domination de Cuda dans l'écosystème GPU, Michael Klemm adopte une stratégie d'ouverture : "Mon approche est que les utilisateurs devraient toujours choisir le standard ouvert et forcer leur fournisseur respectif à proposer la meilleure implémentation possible en logiciel et matériel, car cela crée de la concurrence". OpenMP se différencie des alternatives comme OpenACC par un écosystème plus large et de SYCL par son approche basée sur des pragmas (directives spécifiques au compilateur) plutôt que sur le C++ moderne. Michael Klemm souligne : "Nous ne faisons pas de recherche de pointe en programmation parallèle. Nous standardisons ce que nos utilisateurs font déjà dans leurs logiciels pour rendre cela portable et plus utile".
OpenMP trouve des applications dans des domaines critiques comme la conduite autonome, où la solution Autoware a obtenu une accélération de 2,5x sur les CPU Arm et 3,25x sur les GPU Nvidia Volta. En recherche médicamenteuse, l'organisation a contribué à accélérer la découverte de traitements contre le Covid-19 en combinant MPI pour la distribution système et OpenMP pour la parallélisation au niveau des nœuds. L'identification de virus et la mécanique des fluides pour l'aéronautique constituent d'autres domaines d'application majeurs. Michael Klemm précise : "Dans les simulations de turbulences, OpenMP n'était pas nécessairement utilisé pour le calcul proprement dit, mais plutôt pour la gestion des données, permettant d'éviter les opérations de copie mémoire".
Roadmap et développements futurs
La feuille de route d'OpenMP prévoit des évolutions majeures vers 2029 avec OpenMP 7.0. Les développements attendus incluent un support au niveau du noyau pour périphériques, une approche multi-périphériques avec des opérations accélérées entre les GPU, et des fonctionnalités de diffusion multicast. L'innovation la plus notable concerne l'ajout du support Python, Michael Klemm expliquant : "L'écosystème Python est devenu une partie clé et intégrale du calcul haute performance aujourd'hui, avec PyTorch et TensorFlow écrits en Python". Cette extension vers Python devrait apparaître dans OpenMP 7.0, marquant une évolution significative après près de 30 ans de support exclusif pour C/C++ et Fortran.
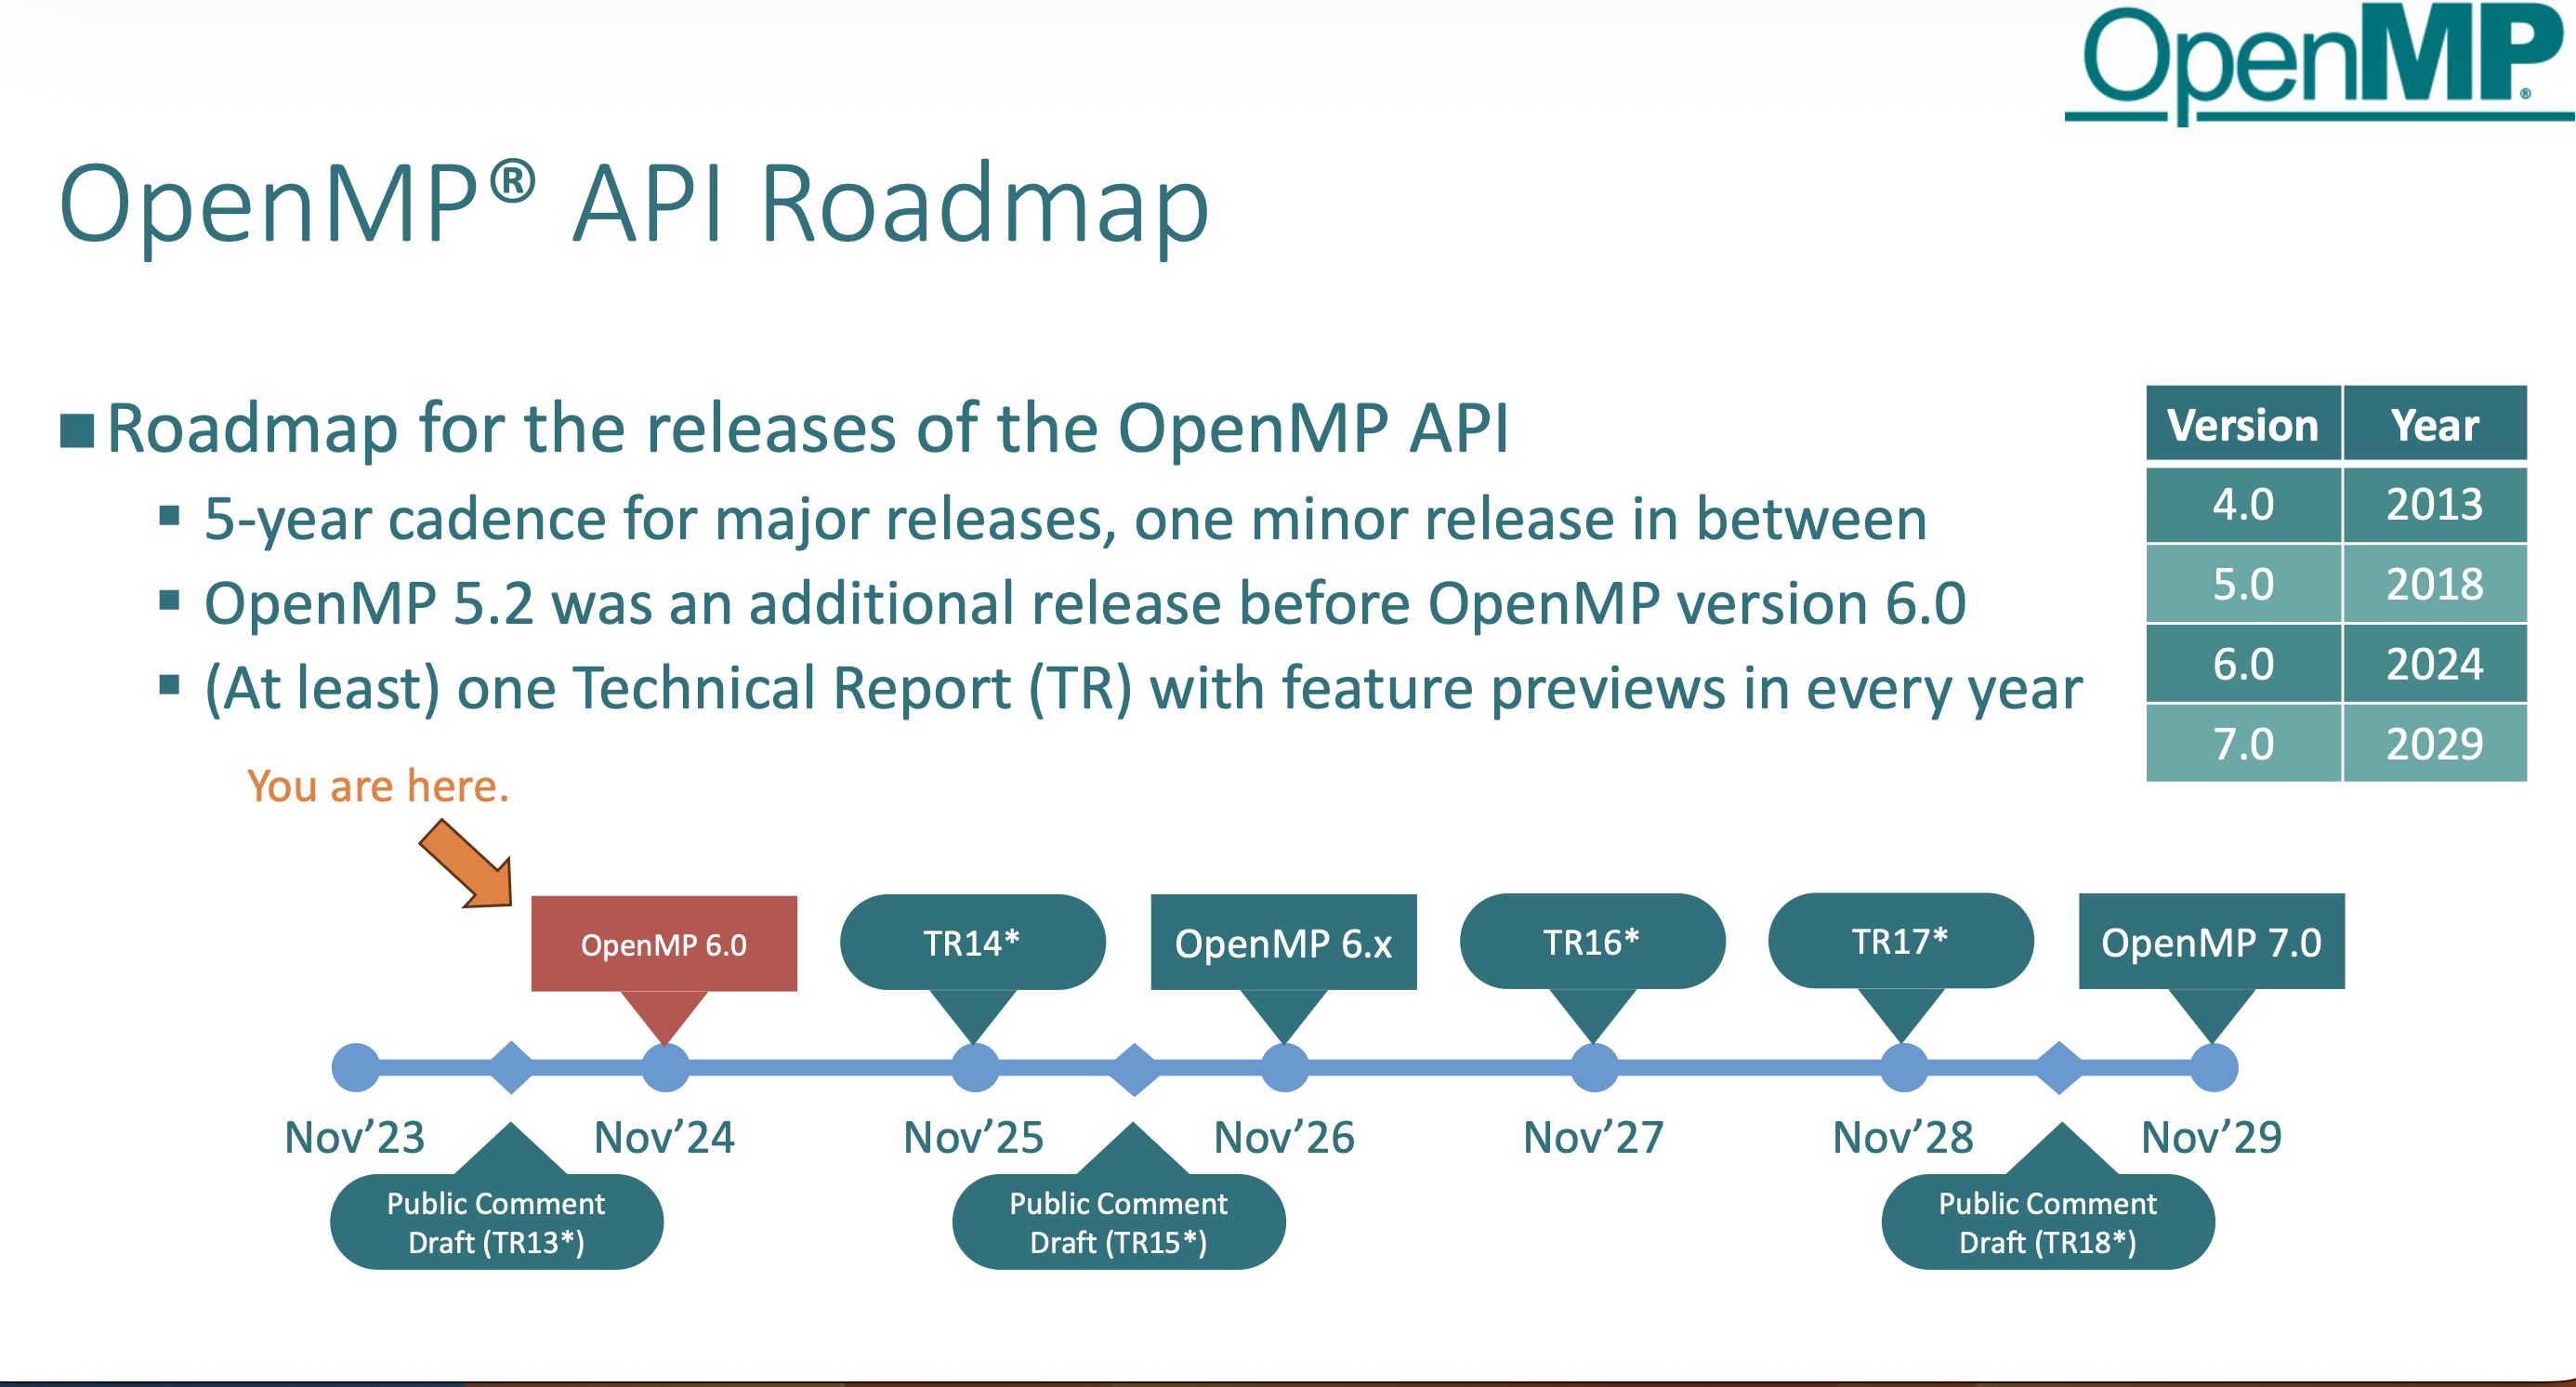
Ambitieuse, la feuille de route d'OpenMP va s'ouvrir à Python.


