
ArticleInfrastructure & Cloud
Économiser du temps et de l'argent avec le serverless (1e partie)
De simples fonctions d'isolation facilitent le développement, et l'exécution pilotée par des événements réduit les coûts opérationnels grâce à l'architecture serverless.

Les développeurs passent énormément de temps à résoudre des problèmes métiers avec du code. Après quoi, c'est au tour de l'équipe des opérations de passer un nombre d'heures incalculable, d'abord à trouver comment récupérer le code écrit par les développeurs et à l’exécuter sur les ordinateurs disponibles, ensuite à vérifier que ces ordinateurs fonctionnent correctement. Cette seconde opération prend vraiment un temps infini. Alors, pourquoi ne pas laisser quelqu'un d'autre s’en charger ?
Ces deux dernières décennies, beaucoup d'innovations IT - machines virtuelles, cloud computing, conteneurs - ont cherché à ce que l’utilisateur ait de moins en moins besoin de se préoccuper de la machine physique sous-jacente sur laquelle est exécutée le code. L’informatique serverless, de plus en plus populaire, est allée au bout de cette logique : avec le serverless, plus besoin de connaître le matériel ou le système d'exploitation sur lequel tourne le code, car tout est pris en charge par un fournisseur de services.
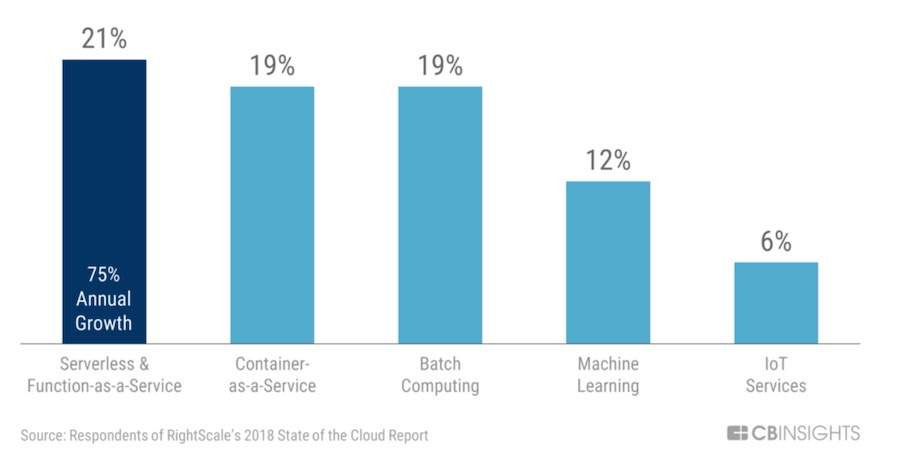
L'architecture serverless connait aujourd'hui la plus forte croissance sur le cloud selon CBInsights.
Qu'est-ce que le serverless ?
Le serverless est un modèle d'exécution pour le cloud dans lequel un fournisseur de services alloue dynamiquement - et facture ensuite à l'utilisateur - uniquement les ressources de calcul et le stockage nécessaires pour exécuter un élément de code particulier. Bien sûr, l’opération implique toujours des serveurs, mais leur approvisionnement et leur maintenance sont entièrement pris en charge par le fournisseur. En 2017, Chris Munns, promoteur de l’informatique serverless chez Amazon, avait déclaré lors d'une conférence que, pour l'équipe qui écrit et déploie le code, « il n'y a aucun serveur à gérer ou à fournir. C’est-à-dire ni bare metal, ni virtuel, ni conteneur. Autrement dit, dans un monde serverless, l’utilisateur doit être exempté de toutes les tâches de gestion et de correctif de l’hôte et ne doit pas se préoccuper de ce qui se passe au niveau du système d'exploitation ».
Comme l'explique le développeur Mike Roberts, le terme a déjà été utilisé pour désigner des scénarios dits « back-end as a service », dans lesquels une application mobile se connecte à un serveur back-end entièrement hébergé dans le cloud. Mais aujourd'hui, lorsqu'on parle d'informatique serverless, ou d'architecture serverless, il s'agit d'offres de fonction-en-tant-que-service, dans lesquelles un client écrit un code qui n'aborde que la logique métiers et charge se code chez un fournisseur. Le fournisseur s'occupe de tout le dimensionnement du matériel, de la gestion des machines virtuelles et des conteneurs, et même des tâches comme le multithreading qui sont souvent intégrées au code de l'application.
Les fonctions serverless sont pilotées par événement, ce qui signifie que le code n'est invoqué que lorsqu'il est déclenché par une requête. Le fournisseur ne facture que le temps de calcul utilisé par cette exécution, plutôt que des frais mensuels fixes pour la maintenance d'un serveur physique ou virtuel. Ces fonctions peuvent être connectées ensemble pour créer un pipeline de traitement, ou bien elles peuvent servir de composants à une application plus large, interagissant avec d'autres codes fonctionnant dans des conteneurs ou sur des serveurs classiques.
Avantages et inconvénients de l'architecture serverless
D'après cette description, les deux plus grands avantages du serverless sont clairs : les développeurs peuvent se concentrer sur les objectifs métiers du code qu'ils écrivent, plutôt que sur les questions d'infrastructure ; et les entreprises ne paient que pour les ressources informatiques qu'elles utilisent réellement d'une manière très granulaire, plutôt que d'acheter du matériel physique ou de louer des instances cloud qui restent pour la plupart du temps en veille.
Comme le souligne Bernard Golden, ce dernier point est particulièrement intéressant pour les applications événementielles. Par exemple, une application peut rester inactive la plupart du temps, mais, dans certaines conditions, doit traiter plusieurs demandes d'événements à la fois. Ou encore, une application qui traite les données envoyées depuis des appareils IoT avec une connectivité Internet limitée ou intermittente. Dans les deux cas, l'approche traditionnelle nécessiterait l'approvisionnement d'un serveur puissant capable de supporter les pics d’activité, mais ce serveur serait sous-utilisé la plupart du temps. Avec une architecture serverless, l’utilisateur ne paye que pour les ressources serveur qu’il utilise réellement. L'informatique serverless est également intéressante pour certains types de traitement par lots. L’un des cas d’usage les plus emblématiques de l’architecture serverless est celui d’un service qui télécharge et traite une série de fichiers image individuels pour les envoyer à une autre partie de l'application.
Pour les usages éphémères
L'inconvénient le plus évident des fonctions serverless, c’est peut-être qu'elles sont intentionnellement éphémères et, comme le dit Alex Soft, « inadaptées aux tâches à long terme ». La plupart des fournisseurs serverless ne laisseront pas votre code s'exécuter pendant plus de quelques minutes, et quand vous lancez une fonction, elle ne conserve aucune donnée d'état des instances exécutées précédemment. Un problème connexe, c’est que le code serverless peut prendre jusqu'à plusieurs secondes pour s’exécuter complètement, ce qui n'est pas un problème pour de nombreux cas d’usage. Mais si votre application nécessite une faible latence, mieux vaut le savoir.
Comme l'ont fait remarquer Rohit Akiwatkar et Gary Arora, beaucoup d'autres inconvénients résultent du lock-in des fournisseurs. Même s’il existe des options open source, le marché de l’informatique serverless est dominé par les grands fournisseurs de cloud, comme nous le verrons plus loin. Cela signifie que les développeurs finissent souvent par utiliser les outils de leurs fournisseurs, si bien qu'il leur est difficile de changer de fournisseur s'ils ne sont pas contents. Et parce qu'une grande partie de l'informatique serverless a lieu, par définition, sur l'infrastructure du fournisseur, il peut être difficile d'intégrer du code serverless dans les pipelines internes de développement et de test.
Pour lire la seconde partie de ce sujet, suivez ce lien.
