
ArticleInfrastructure & Cloud
Comment Azure prend en charge les grands workloads d'IA
Lors de sa dernière conférence Build, Microsoft a décrit comment Azure prend maintenant en charge les grands workloads d'intelligence artificielle. Son secret : un accélérateur d'inférence, des connexions à large bande passante et des outils d'efficacité et de fiabilité.

Les présentations annuelles de Mark Russinovich, directeur technique d'Azure, sur l'infrastructure Azure lors des conférences Build de Microsoft sont toujours fascinantes, car il explore le passé, le présent et l'avenir du matériel qui sous-tend son cloud. La présentation de cette année n'était pas différente alors qu'au fil des ans il est clair que le matériel d'Azure devient de plus en plus complexe. Au début, il s'agissait de montrer un excellent exemple d'informatique de commodité utilisant un seul modèle de serveur standard. Aujourd'hui, de nombreux types de serveurs différents ont émergé, capables de prendre en charge des classes de charges de travail très nombreuses et variées, avec l'ajout de GPU et maintenant d'accélérateurs d'IA. Cette dernière innovation, introduite en 2023, donne l'occasion de voir à quel point l'infrastructure d'Azure a évolué en même temps que les workloads qu'elle héberge. La première slide de Mark Russinovich montrait la rapidité avec laquelle les modèles d'IA modernes se développaient, passant de 110 millions de paramètres avec GPT en 2018 à plus d'un trillion dans GPT-4o d'aujourd'hui. Cette croissance a conduit au développement de supercalculateurs distribués massifs pour entraîner ces modèles, ainsi que du matériel et des logiciels pour les rendre efficaces et fiables.
Le volume de systèmes nécessaires pour faire fonctionner ces plateformes d'IA est énorme. Le premier grand supercalculateur de formation à l'IA de Microsoft a été présenté en détail en mai 2020. Il disposait de 10 000 GPU Nvidia V100 et occupait la cinquième place du classement mondial des supercalculateurs Top 500. Trois ans plus tard, en novembre 2023, la dernière itération comptait 14 400 GPU H100 et se classait troisième du Top 500. En juin 2024, Microsoft disposera de plus de 30 supercalculateurs similaires dans des datacenters du monde entier. Mark Russinovich a parlé du modèle open source Llama-3-70B, qui nécessite 6,4 millions d'heures de GPU pour s'entraîner. Sur un seul GPU, cela prendrait 730 ans, mais avec l'un des grands systèmes d'IA de Microsoft, un entraînement prend environ 27 jours.La formation n'est qu'une partie du problème. Une fois qu'un modèle a été construit, il doit être utilisé, et bien que l'inférence ne nécessite pas des niveaux de calcul de supercalculateur pour la formation, elle a toujours besoin de beaucoup de puissance. Comme le note Mark Russinovich, un seul paramètre en virgule flottante nécessite deux octets de mémoire, un modèle d'un milliard de paramètres nécessite 2 Go de RAM et un modèle de 175 milliards de paramètres nécessite 350 Go. Et ce, avant d'ajouter tous les frais généraux nécessaires, tels que les caches, qui peuvent ajouter plus de 40 % à des besoins en mémoire déjà considérables. Azure a donc besoin d'un grand nombre de GPU présentant des caractéristiques très spécifiques pour traiter un grand nombre de données aussi rapidement que possible. Les modèles tels que le GPT-4 nécessitent des quantités importantes de mémoire à large bande passante. Le calcul et la mémoire ont tous deux besoin d'une puissance substantielle. Un GPU Nvidia H100 nécessite ainsi 700 watts, et avec des milliers de GPU en fonctionnement à tout moment, les datacenters Azure doivent donc évacuer beaucoup de chaleur.
Un accélérateur d'inférence maison
Microsoft a développé son propre accélérateur d'inférence, avec sa puce Maia, et à l'origine d'un dernier système managé de refroidissement liquide en boucle fermée embarquant des accélérateurs ayant nécessité une toute nouvelle conception de rack avec une armoire secondaire contenant les échangeurs de chaleur de l'équipement de refroidissement. La conception de datacenters pour l'apprentissage a montré à Microsoft comment prévoir l'inférence. En utilisant la même surveillance de l'alimentation sur un rack d'inférence, il est possible de voir comment la consommation d'énergie varie à différents moments d'une opération d'inférence. Le projet Polca d'Azure vise ainsi à utiliser ces informations pour améliorer leur efficacité. Il permet à plusieurs opérations d'inférence de fonctionner en même temps en prévoyant une consommation d'énergie maximale en hausse d'environ 20 %. Cela permet à Microsoft de placer 30 % de serveurs en plus dans un datacenter en régulant à la fois la fréquence et la puissance des serveurs. Le résultat est une approche plus efficace et plus durable des besoins en calcul, en énergie et en chaleur d'un datacenter d'intelligence artificielle même si on sait qu'il reste encore beaucoup à faire en termes d'impact carbone.
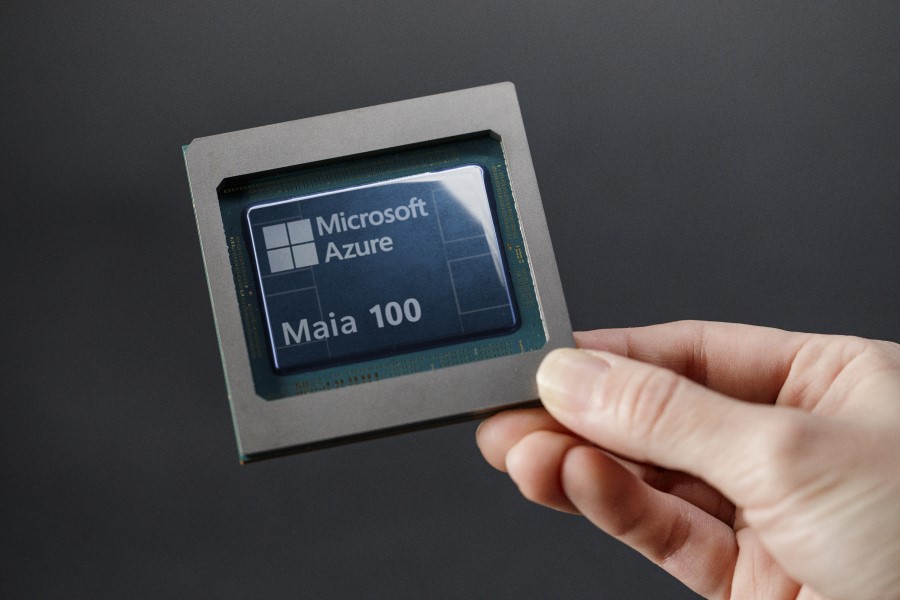
La puce Maia 100 de Microsoft a été spécialement développée pour les besoins IA d'Azure. (Crédit Microsoft)
La gestion des données pour les modèles d'entraînement pose par ailleurs son lot de problèmes : les données sont nombreuses et doivent être réparties entre les nœuds de ces supercalculateurs Azure. Le fournisseur a travaillé sur ce qu'elle appelle Storage Accelerator pour gérer ces données, en les distribuant sur les clusters avec un cache qui détermine si les données requises sont disponibles localement ou si elles doivent être récupérées, en utilisant la bande passante disponible pour éviter d'interférer avec les opérations en cours. L'utilisation de lectures parallèles pour charger les données permet de charger de grandes quantités de données de formation presque deux fois plus vite que les chargements de fichiers traditionnels.
L'IA a besoin de réseaux à large bande passante
Le calcul et le stockage sont également importants, mais la mise en réseau reste cruciale, en particulier pour les charges de travail parallèles aux données massives qui fonctionnent sur plusieurs centaines de GPU. La firme de Redmond a ainsi investi de manière significative dans des connexions InfiniBand à large bande passante, utilisant 1,2 Tbps de connectivité interne dans ses serveurs, reliant 8 GPU, et en même temps 400 Gbps entre les GPU individuels dans des serveurs séparés. Cela a aussi été le cas pour ses supercalculateurs de formation Open AI et pour son service client. Il est intéressant de noter que Mark Russinovich a expliqué que "la seule différence entre les supercalculateurs que nous construisons pour OpenAI et ceux que nous mettons à la disposition du public, c'est l'échelle du domaine InfiniBand. Dans le cas d'OpenAI, le domaine InfiniBand couvre l'ensemble du supercalculateur, soit des dizaines de milliers de serveurs ". Pour d'autres clients qui n'ont pas les mêmes exigences en matière de formation, les domaines sont plus petits, mais représentent tout de même 1 000 à 2 000 serveurs, connectant 10 000 à 20 000 GPU. Toute cette infrastructure de réseau nécessite des solutions étonnamment peu technologiques, telles que des traîneaux imprimés en 3D pour tirer efficacement de grandes quantités de câbles. Ces traîneaux sont placés dans les étagères à câbles situées au-dessus des racks de serveurs et tirés le long de ceux-ci. Ils constituent un moyen simple pour réduire considérablement les temps de câblage, une nécessité lorsque l'on construit 30 supercalculateurs tous les six mois.
Le matériel n'est qu'une partie de l'histoire d'Azure. La pile logicielle fournit les outils d'orchestration et d'assistance de la plateforme sous-jacente. C'est là que Project Forge entre en jeu. On peut le considérer comme un équivalent de Kubernetes, un moyen de planifier les opérations sur une infrastructure distribuée tout en fournissant une gestion essentielle des ressources et en répartissant les charges sur les différents types de calcul de l'IA.
Rendre l'IA fiable : Project Forge et One Pool
Le planificateur Project Forge traite tous les accélérateurs d'IA disponibles dans Azure comme un seul pool virtuel de capacités GPU, ce que Microsoft appelle One Pool. Les charges ont des niveaux de priorité qui contrôlent l'accès à ces GPU virtuels. Une charge plus prioritaire peut évincer une charge moins prioritaire, en la déplaçant vers une autre classe d'accélérateur ou vers une autre région. L'objectif est de fournir un niveau d'utilisation cohérent sur l'ensemble de la plateforme Azure AI afin que Microsoft puisse mieux planifier et gérer son budget d'alimentation et de mise en réseau. Comme Kubernetes, Project Forge est conçu pour aider à exécuter un service plus résilient, en détectant les défaillances, en redémarrant les tâches et en réparant la plateforme hôte. En automatisant ces processus, Azure peut éviter d'avoir à redémarrer des tâches coûteuses et complexes, en les traitant plutôt comme un ensemble de lots qui peuvent s'exécuter individuellement et orchestrer les entrées et les sorties en fonction des besoins.
Une fois qu'un modèle d'IA a été construit, il doit être utilisé. Là encore, Azure a besoin d'un moyen d'équilibrer l'utilisation entre les différents types de modèles et les différentes invites au sein de ces modèles. En l'absence d'orchestration efficace, il est facile de se retrouver dans une situation où une invite finit par bloquer d'autres opérations. En tirant parti de ses GPU virtuels fractionnés, le projet Flywheel d'Azure peut quant à lui garantir les performances, en entrelaçant les opérations de plusieurs invites sur des GPU virtuels, ce qui permet des opérations cohérentes sur le GPU physique de l'hôte tout en fournissant un débit constant. Une autre optimisation de bas niveau concerne les capacités de calcul confidentielles lors de la formation de modèles personnalisés. Vous pouvez exécuter du code et héberger des données dans des environnements d'exécution fiables. Azure est désormais en mesure d'avoir des VM entièrement confidentielles, y compris des GPU, avec des messages chiffrés entre les environnements de confiance du CPU et du GPU. Il est aussi possible de l'utiliser pour la formation ou la sécurisation de vos données privées utilisées pour la génération augmentée par récupération.
La présentation de Mark Russinovich montre clairement que Microsoft investit massivement pour rendre son infrastructure d'IA plus efficace et réactive pour l'entraînement et l'inférence. Les équipes chargées de l'infrastructure et de la plateforme Azure ont beaucoup travaillé à la mise au point de matériel et de logiciels capables de prendre en charge l'entraînement des plus grands modèles, tout en fournissant un endroit sûr et fiable pour utiliser l'IA dans des applications. L'exécution d'Open AI sur Azure a permis à ces équipes d'acquérir une grande expérience, et il est bon de voir que cette expérience porte ses fruits en fournissant les mêmes outils et techniques pour d'autres entreprises. Même si beaucoup d'entre elles n'ont sans doute vraiment pas besoin des mêmes puissances de calcul que les supercalculateurs du Top 500.
