
ArticleInfrastructure & Cloud
Comment déployer du machine learning sur AWS Lambda
Le service serverless d'AWS, Lambda, fournit une solution simple, évolutive et rentable pour le déploiement de modèles d'IA qui élimine le besoin de licences et d'outils coûteux. Le point sur deux approches et étapes à suivre pour sa mise en oeuvre.

Dans le domaine en pleine évolution de l'intelligence artificielle et de l'apprentissage automatique, les entreprises continuent de rechercher des solutions rentables pour réduire leur dépendance vis-à-vis d'outils tiers coûteux, non seulement pour le développement, mais aussi pour le déploiement. Récemment, j'ai été chargé de déployer un modèle d'apprentissage automatique prédictif (ML) dans mon entreprise. Notre objectif initial était d'internaliser le modèle ML afin de réduire les coûts opérationnels, mais le processus de déploiement présentait des défis importants en raison des exigences coûteuses en matière d'infrastructure.
C'est là qu'intervient le serverless, avec des plateformes telles qu'AWS Lambda qui offrent une solution convaincante pour une inférence ML légère et à la demande. Elle est une option particulièrement opportune compte tenu de l'essor de l'informatique edge et des cas d'utilisation de l'apprentissage automatique, ainsi que de la nécessité de réduire les coûts excessifs traditionnellement associés au déploiement du ML. Dans cet article, je vais vous présenter deux façons de déployer un modèle ML sur AWS Lambda. Il s'agit d'un choix privilégié car la solution est simple, automatiquement évolutive et rentable, puisque seules les requêtes effectuées sont payées.
Pourquoi utiliser Lambda pour déployer des modèles ML
Cette solution est convaincante pour le déploiement de modèles, avec un véritable service à la carte. Ses principaux avantages sont les suivants. Rentabilité : pour les entreprises traitant entre 1 000 et 10 000 prédictions par jour, le calcul serverless peut potentiellement réduire les coûts d'infrastructure jusqu'à 60 % par rapport à la maintenance de serveurs de prédiction dédiés. Évolutivité : Lambda adapte automatiquement les ressources informatiques en fonction des demandes de prédiction entrantes, sans intervention manuelle. En éliminant le besoin de pré-provisionner la capacité des serveurs, les sociétés peuvent optimiser l'utilisation des ressources et réduire considérablement les frais généraux liés à l'infrastructure. Bien que cette offre excelle dans de nombreux scénarios, il est essentiel d'évaluer ses limites et contraintes afin de déterminer si elle répond à vos besoins spécifiques en matière de déploiement ML.
Première approche : Déploiement d'un modèle stocké sur S3
Le déploiement d'un modèle ML sous forme de fichier Python pickle dans un bucket S3 et son utilisation via une API Lambda rend le déploiement du modèle simple, évolutif et rentable. Nous avons configuré AWS Lambda pour charger ce modèle depuis S3 lorsque cela est nécessaire, ce qui permet d'obtenir des prédictions rapides sans avoir besoin d'un serveur dédié. Lorsqu'un utilisateur appelle l'API connectée à la fonction Lambda, le modèle est récupéré, exécuté et renvoie des prédictions basées sur les données saisies. Cette configuration serverless garantit une haute disponibilité, s'adapte automatiquement et réduit les coûts, car vous ne payez que lorsque l'API est utilisée.
Etape 1 : Créer une archive zip pour la couche Lambda
Une couche Lambda est une archive zip qui contient des bibliothèques, un runtime personnalisé et d'autres dépendances. Je vais vous montrer comment créer une couche Lambda à l'aide de deux bibliothèques Python, Pandas et Scikit-learn, qui sont souvent utilisées dans les modèles ML. Vous trouverez ci-dessous le code permettant de créer une archive zip de couche Lambda contenant Pandas et Scikit-learn à l'aide de Docker. Créez un fichier, nommez-le createlayer.sh et copiez le code.
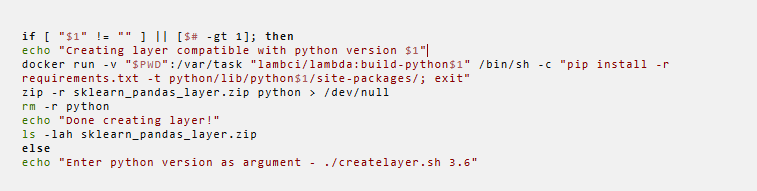
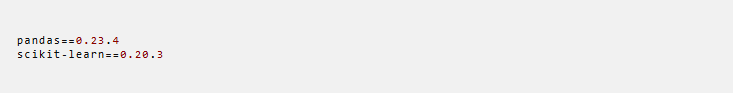
Maintenant, dans le même répertoire, créez un fichier nommé requirements.txt pour stocker les noms et les versions des bibliothèques dans la couche. Dans ce cas, notre fichier requirements.txt répertorie les noms et les versions des bibliothèques Pandas et Scikit-learn que nous utilisons.
Ensuite, dans le terminal, accédez au répertoire où vous avez placé les fichiers createlayer.sh et requirements.txt, puis exécutez la commande ci-dessous pour générer le fichier zip de la couche Lambda.

Lorsque la commande shell ci-dessus est exécutée, celle pip install incluse dans le script shell télécharge automatiquement Pandas, Scikit-learn et leurs dépendances depuis le Python Package Index (PyPI) et les installe directement dans le répertoire python/lib/python$1/site-packages/. Une fois le script shell terminé, vous constaterez que le fichier zip Lambda layer généré contient des dossiers pour Pandas, Scikit-learn, NumPy et SciPy, ainsi que certains fichiers Python.
Etape 2 : Stockez le modèle ML et les fichiers de la couche Lambda dans S3
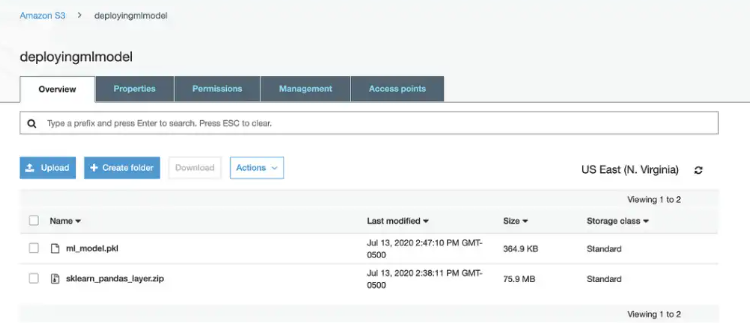
Créez un nouveau dossier dans un bucket S3 et donnez-lui le nom de votre fonction Lambda pour le déploiement du modèle ML (par exemple, DeployMlModel). Copiez le fichier Python pickle de votre modèle ML et le fichier zip de votre couche Lamba dans le dossier. Une fois les fichiers copiés, votre bucket S3 devrait afficher le dossier et son contenu, comme illustré dans la figure 1 ci-dessous.
(crédit : Foundry)
Etape 3 : Créer la fonction Lambda
1. Accédez à la console AWS Lambda et cliquez sur « Créer une fonction » 2. Sélectionnez « Créer à partir de zéro » 3. Saisissez le nom de la fonction (par exemple, DeployMlModel) 4. Sélectionnez le runtime (par exemple, Python 3.6) 5. Sélectionnez ou créez un rôle d'exécution approprié avec l'autorisation de lire depuis Amazon S3 6. Cliquez sur « Créer une fonction ».
À ce stade, vous disposez d'une fonction Lambda vide prête à être configurée.
Étape 4 : Ajoutez la couche Lambda à la fonction Lambda
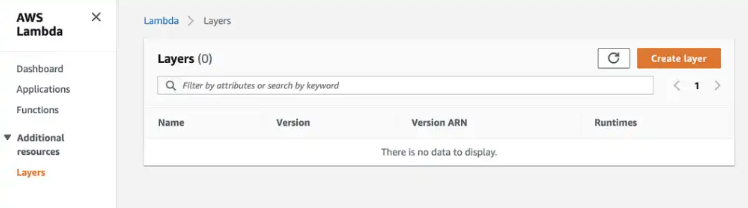
Dans cette étape, nous configurons Lambda pour utiliser le fichier zip Lambda Layer que nous avons créé et stocké dans S3 à l'étape 2. Pour ajouter notre fichier zip Lambda Layer à Lambda, nous cliquons sur « Layers », puis sur « Create Layer » dans l'interface utilisateur Lambda, comme illustré dans la figure ci-dessous.
(crédit : Foundry)
Ensuite, entrez le nom, la description, l'URL S3 et les autres propriétés de notre couche Lambda comme indiqué dans la figure ci-dessous, puis cliquez sur Enregistrer.
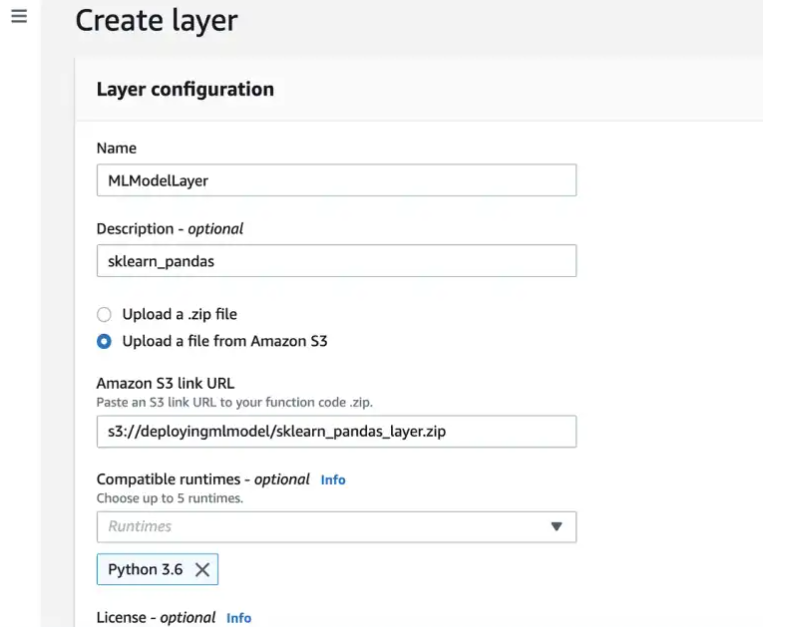
(crédit : Foundry)
Une fois la nouvelle couche Lambda créée, vous devriez recevoir un message « Couche créée avec succès » en haut de la fenêtre, comme illustré dans la figure ci-dessous.
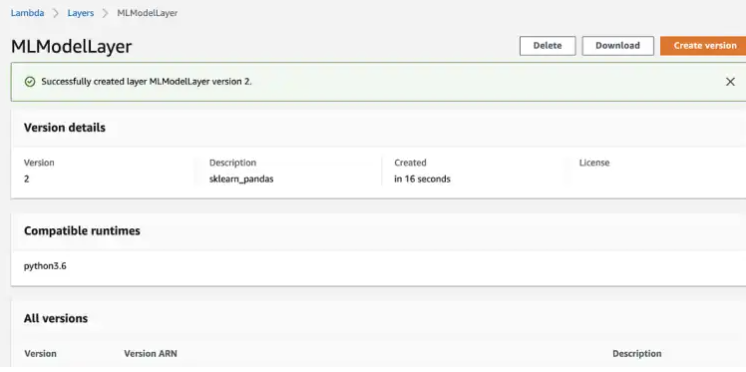
(crédit : Foundry)
Quelques points clés à retenir concernant les couches Lambda :
1. Les couches Lambda doivent être des fichiers compressés 2. Vous pouvez avoir au maximum cinq couches Lambda pour une fonction Lambda donnée 3. La taille totale décompressée de la fonction Lambda et de ses couches ne peut pas dépasser 250 Mo
Maintenant, pour ajouter cette couche à votre fonction Lambda, accédez à la fonction Lambda que vous avez créée à l'étape 3, cliquez sur « Couches » et choisissez l'option « Couches personnalisées ». Reportez-vous aux deux captures ci-dessous pour voir ce qu'il en est.
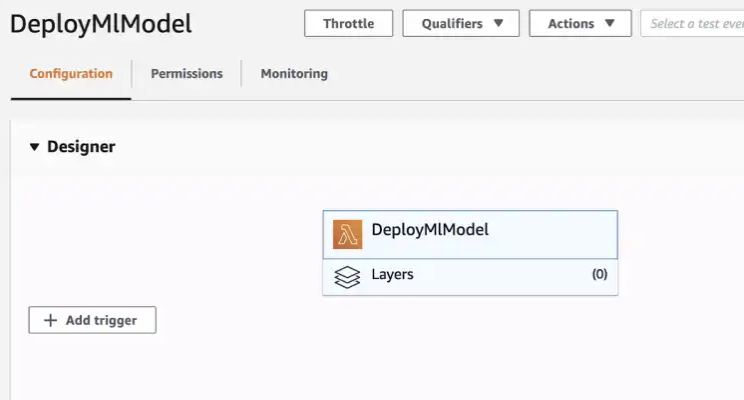
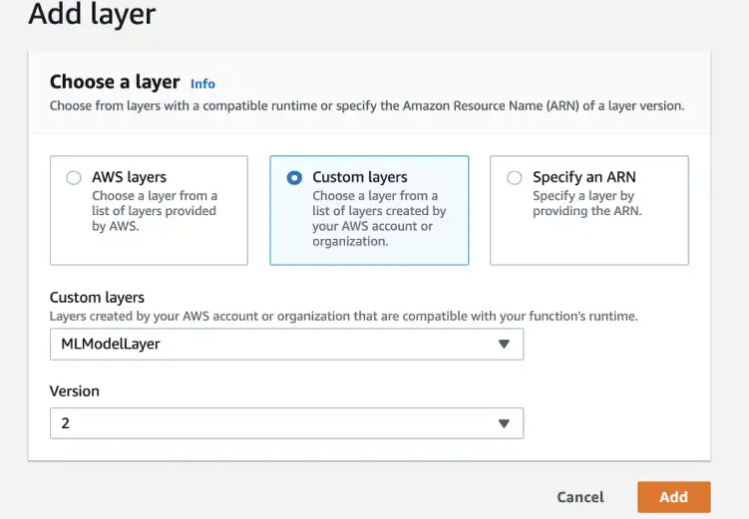
Dans les menus déroulants « Couches personnalisées », sélectionnez le nom et la version de la couche Lambda, puis cliquez sur « Ajouter » pour l'ajouter à la fonction Lambda.
Étape 5 : Ajoutez le code de la fonction Lambda
Ensuite, nous allons ajouter le code de la fonction Lambda qui utilise le modèle ML.
1. Dans la console Lambda, ouvrez la fonction Lambda (DeployMlModel) que vous avez créée 2. Dans le menu de gauche, cliquez sur « Code » 3. Dans l'éditeur en ligne, remplacez le contenu par défaut par le code suivant :
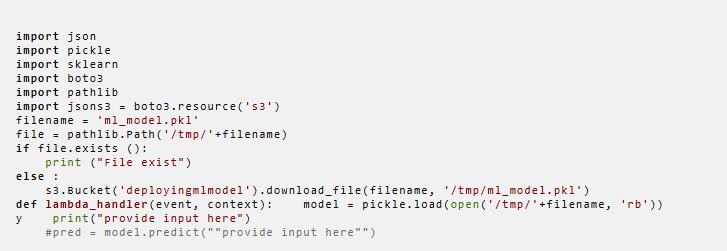
Votre fonction Lambda devrait désormais inclure une couche et le code indiqué ci-dessus. Reportez-vous à la suivante pour vous en rendre compte.
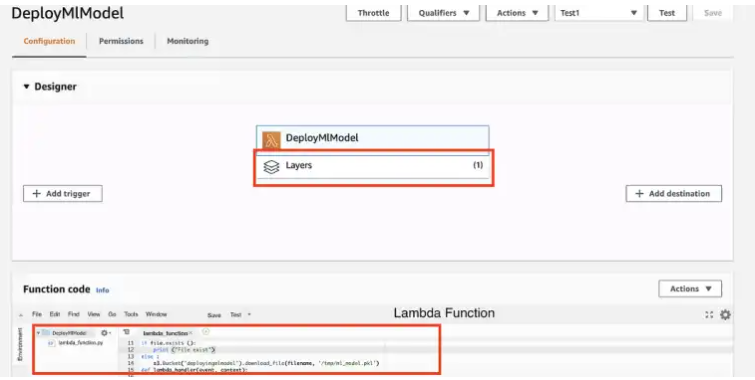
(crédit : Foundry)
Bravo ! Vous avez déployé avec succès votre modèle ML sur Lambda. Pour tester votre fonction Lambda, accédez à l'onglet « Test » dans la console. Créez un événement de test en cliquant sur « Configurer l'événement de test », fournissez une charge utile JSON simple (c'est-à-dire une entrée attendue par votre modèle), puis cliquez sur « Tester ». La fonction devrait s'exécuter, charger le modèle depuis Amazon S3 et renvoyer le résultat dans la console. Cela vous permet de vérifier rapidement que votre déploiement fonctionne correctement et de visualiser les prédictions générées par votre modèle ML.
Deuxième approche : Packager le modèle avec le déploiement AWS Lambda
Cette approche consiste à compresser le fichier pickle du modèle ML avec la fonction Lambda, puis à télécharger l'ensemble directement vers AWS Lambda. Enregistrez le code de la fonction Lambda de l'étape 5 ci-dessus dans un fichier nommé Predict.py, puis compressez-le avec le fichier pickle du modèle ML (par exemple, ml_model.pkl) pour créer une archive compressée. Reportez-vous à la figure 8 ci-dessous pour connaître le contenu de l'archive compressée.
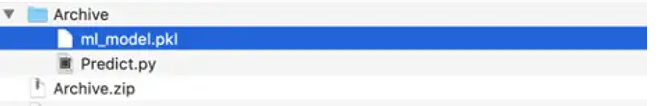
(crédit : Foundry)
Maintenant, téléchargez ce fichier compressé vers AWS Lambda à l'aide de l'option « Télécharger un fichier .zip » mise en évidence dans la capture ci-dessous.
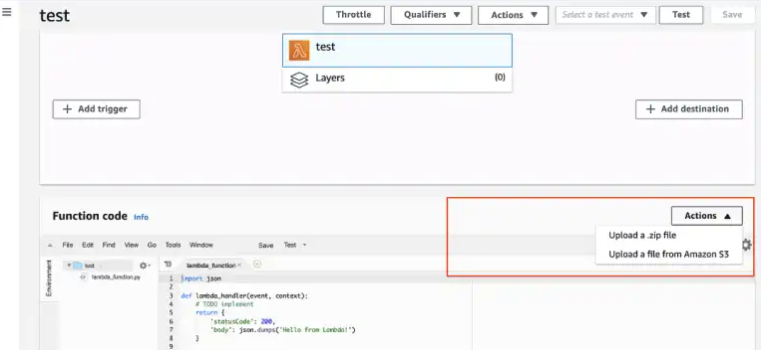
(crédit : Foundry)
Si la taille de votre fichier zip est inférieure à 10 Mo, vous pouvez le télécharger à partir d'ici. Sinon, téléchargez d'abord le fichier zip sur S3, puis utilisez l'option « Télécharger un fichier depuis Amazon S3 » pour l'ajouter à Lambda à partir de là. Cette instruction est affichée en petits caractères dans la fenêtre « Télécharger un fichier .zip », comme illustré ci-dessous.
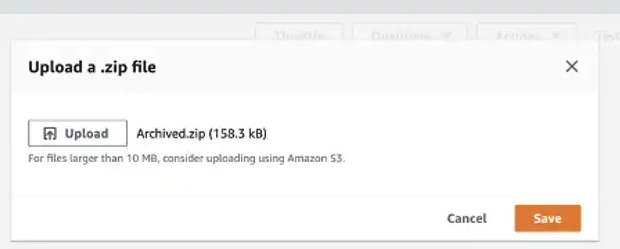
(crédit : Foundry)
Cliquez sur Enregistrer. Une fois votre fichier téléchargé, affichez votre fonction Lambda. Le fichier .pkl et le fichier .py devraient apparaître dans le dossier d'archive, comme le montre la capture ci-dessous.
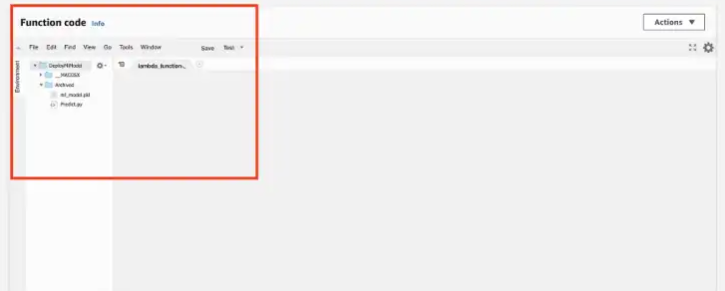
(crédit : Foundry)
Bien joué : Vous avez déployé avec succès le modèle ML au format zip avec le code de la fonction Lambda.
Applications concrètes et limites
Le déploiement ML serverless est particulièrement adapté aux cas d'utilisation à faible volume et à la demande, tels que les chatbots d'assistance à la clientèle, les API de reconnaissance d'images et d'autres tâches d'inférence légères à la périphérie, réduisant ainsi la dépendance vis-à-vis des centres de données centraux. TradeIndia.com, un portail commercial B2B, utilise Lambda pour exécuter des modèles ML légers pour l'analyse en temps réel des données clients. Grâce au déploiement de leur modèle serverless, ils ont réduit leurs coûts d'infrastructure de 25 % à 30 %, ce qui leur a permis de réinvestir ces économies dans l'élargissement de leur offre de services.
Bien sûr, ce service présente également des limites. Pour le déploiement de modèles, la principale limitation est la restriction de taille de package de 250 Mo, qui peut poser un problème pour les modèles complexes. Pour pallier cette contrainte, les développeurs peuvent recourir à des techniques d'atténuation telles que la compression des modèles, l'ingénierie sélective des fonctionnalités et la gestion efficace des dépendances. La modularisation des composants des modèles et la mise en œuvre d'architectures hybrides combinant une infrastructure serverless et une infrastructure traditionnelle peuvent aider à surmonter les limitations de taille sans sacrifier les performances des modèles. Un autre défi est celui des « démarrages à froid » où les invocations initiales de fonctions peuvent connaître des pics de latence de 10 à 12 secondes, ce qui contraste fortement avec les réponses quasi instantanées des environnements de serveurs dédiés. Lors de la première invocation, Lambda doit télécharger l'image du conteneur dans son environnement d'exécution, ce qui entraîne un temps de réponse supplémentaire. Cette latence est particulièrement perceptible dans les scénarios nécessitant des réponses à faible latence. Pour atténuer ce problème, vous pouvez configurer un événement Lambda déclenché par CloudWatch afin d'invoquer périodiquement la fonction Lambda, la maintenant ainsi « chaude » et prête à être exécutée, ce qui réduit les délais. De plus, cette configuration peut être optimisée pour ne s'exécuter que pendant des plages horaires spécifiques, telles que les heures de bureau, afin d'équilibrer les performances et les coûts. Cette approche garantit que le modèle ML reste disponible sans entraîner de coûts d'exécution inutiles.
En conclusion, le déploiement d'un modèle ML à l'aide de Lambda offre une solution évolutive et rentable qui élimine le besoin d'outils de licence et de déploiement coûteux. Les deux approches évoquées (lecture du modèle ML à partir d'un bucket S3 et compression du modèle avec le code de la fonction Lambda) offrent une certaine flexibilité pour répondre à différents scénarios de déploiement. Bien que l'architecture de cette offre soit efficace, le fait de remédier à la latence au démarrage à froid à l'aide de techniques telles que le préchauffage de la fonction Lambda vous aidera à garantir des performances optimales, même pour le premier appel API. En combinant rentabilité et optimisation des performances, cette méthode de déploiement des modèles ML s'impose comme un choix pratique pour les entreprises qui cherchent à maximiser la valeur et à réduire les dépenses.
