
ArticleDonnées & IA
Nvidia entend accélérer l'inférence avec son orchestrateur open source Dynamo
Selon le fournisseur de puces, son logiciel d'inférence open source, appelé à remplacer le serveur d'inférence Triton, augmente le débit et réduit le coût de génération de jetons LLM.
Présenté lors de la conférence GTC 2025 qui se tient du 17 au 20 mars à San José, en Californie, le logiciel d'inférence open oource Dynamo permettra aux entreprises d'augmenter le débit et de réduire les coûts lors de l'utilisation de grands modèles de langage sur les GPU Nvidia. « Orchestrer et coordonner efficacement les demandes d'inférence d'IA sur une grande flotte de GPU est crucial pour s'assurer que les usines d'IA (groupe de puces exécutant des charges de travail d'IA) fonctionnent au coût le plus bas possible afin de maximiser la génération de revenus de jetons », a déclaré Nvidia dans un communiqué. Le fournisseur de puces estime qu’avec la prolifération de l'IA générative, l'adoption des LLM de raisonnement va augmenter, entraînant à son tour des charges de travail d'inférence. Toute solution pour réduire le coût de ces charges de travail sera donc bénéfique pour les entreprises, car elle garantira des cas d’usage meilleurs et plus rapides de l'IA générative pour les consommateurs finaux. Selon un rapport de MarketsAndMarkets, le marché mondial de l'inférence de l'IA devrait passer de 106,15 milliards de dollars en 2025 à 254,98 milliards de dollars d'ici à 2030.
Un successeur pour le serveur d'inférence Triton
Dynamo succèdera au serveur d'inférence Triton, le projet open source introduit en 2018 par Nvidia pour optimiser et servir les modèles d'apprentissage machine pour l'inférence dans les environnements de production afin d'assurer une utilisation efficace des GPU et des CPU. Selon l’entreprise, Dynamo sera plus efficace grâce à sa capacité à orchestrer et à accélérer la communication de l'inférence sur des milliers de GPU. « Le logiciel utilise un service désagrégé pour séparer les phases de traitement et de génération de grands modèles de langage (LLM) sur différents GPU, de sorte que chaque phase peut être optimisée indépendamment pour ses besoins spécifiques et garantit une utilisation maximale des ressources GPU », a expliqué la société. Ce gain d'efficacité est rendu possible par la capacité de Dynamo à cartographier les connaissances que les systèmes d'inférence conservent en mémoire à partir des requêtes antérieures, une spécificité connue sous le nom de cache KV, sur des milliers de GPU. « Dynamo achemine ensuite les nouvelles demandes d'inférence vers les GPU qui ont la meilleure correspondance de connaissances, ce qui évite les recalculs coûteux et libère les GPU pour répondre aux nouvelles demandes », a fait valoir Nvidia.

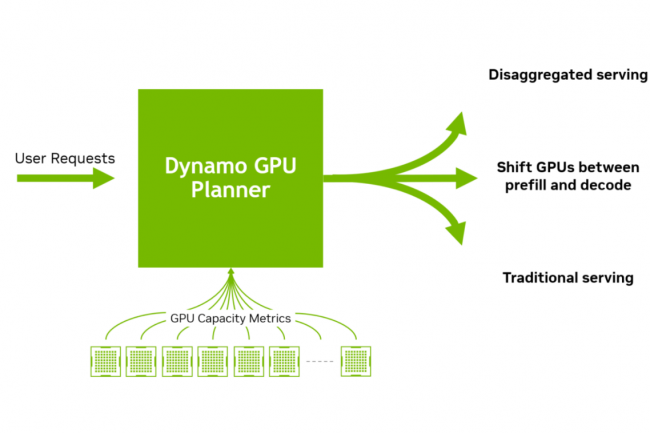
Pour permettre une inférence distribuée et désagrégée à grande échelle, Dynamo comprend 4 innovations clés : Dynamo Planner, Dynamo Smart Router, Dynamo Distributed KV Cache Manage et Inference Transfer Library (NIXL). (Crédit Nvidia)
Dynamo, meilleur que vLLM et SG Lang
Par rapport à son prédécesseur, Dynamo comprend quatre améliorations qui peuvent contribuer à réduire les coûts de service d'inférence, notamment un planificateur de GPU GPU Planner, un routeur intelligent Smart Router, une bibliothèque de communication à faible latence (low-latency Communication Library) et un gestionnaire de mémoire Memory Manager. Le GPU Planner permet aux entreprises d'utiliser Dynamo pour ajouter, supprimer et réaffecter des GPU en fonction de la fluctuation des volumes et des types de requêtes, afin d'éviter le sur-provisionnement ou le sous-provisionnement des GPU, tandis que la bibliothèque de communication à faible latence permet une communication de GPU à GPU et un transfert de données plus rapide. « Quant à la mise à jour Smart Router, elle permettra aux entreprises d'utiliser Dynamo pour localiser des GPU spécifiques dans de grands clusters qui peuvent minimiser les calculs de réponse et acheminer les requêtes », a expliqué Nvidia. « De plus, les entreprises pourront utiliser la capacité Memory Manager de Dynamo pour décharger les données d'inférence vers des dispositifs de mémoire et de stockage plus abordables et les récupérer rapidement en cas de besoin, minimisant ainsi les coûts d'inférence », a ajouté l’entreprise.
Le fabricant affirme qu’avec Dynamo, il a pu générer 30 fois plus de jetons par GPU lors de l'exécution du modèle DeepSeek-R1 sur un grand cluster de racks NVL72 GB200 et doubler les performances des GPU Hopper servant les modèles Llama. Mais Abhivyakti Sengar, directeur des pratiques chez Everest Group, n'est pas convaincu par ces affirmations. « Une réduction des coûts de 30 fois et une inférence plus rapide est certes intéressante, mais les entreprises devront tester ces optimisations dans des charges de travail réelles », a tempéré M. Sengar, ajoutant que si Dynamo tient ses promesses, il pourrait redéfinir le raisonnement de l'IA à l'échelle, rendant les applications de l'IA plus accessibles et plus rentables. M. Sengar fait aussi remarquer que la nature open-source du logiciel transfère la responsabilité de l'intégration, de l'optimisation et de la sécurité aux entreprises, et que ces facteurs détermineront son véritable impact dans les environnements de production.
Disponibilité via les microservices NIM et la plateforme AI Enterprise
Nvidia précise que Dynamo sera disponible via ses microservices NIM et pris en charge dans une future version de la plateforme logicielle AI Enterprise. En outre, la firme a conclu des partenariats avec des fournisseurs de services cloud et d'autres fournisseurs, tels qu'Oracle, AWS, Microsoft, IBM et Google Cloud, pour rendre ses microservices NIM disponibles via leurs plates-formes IA d'entreprise telles que OCI, Vertex AI et Azure AI Foundry, entre autres. Dynamo prend en charge PyTorch, SGLang et vLLM et les entreprises pourront également servir des modèles d'IA dans des scénarios d'inférence désagrégés.