ArticleApplications & Développement
Slopsquatting : les hallucinations des IA se transforment en menace
Des chercheurs ont découvert une technique où des attaquants peuvent utiliser et distribuer des paquets recommandés mais surtout inventés par des modèles IA.
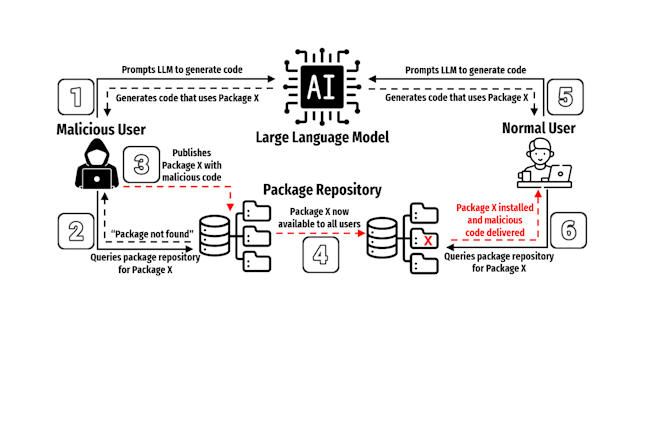
La sécurité des modèles d’IA est devenue un sujet important. Plusieurs techniques existent pour faire plier les garde-fous et corrompre les résultats : empoisonnement de données, usage de langage méconnu, …. Une équipe de l'université du Texas à San Antonio, de Virginia Tech et de l'université d'Oklahoma vient d’en trouver une autre qui s’appuie sur la capacité des LLM à halluciner du code. Nommée slopsquatting, elle constitue une menace pour le cycle de développement des logiciels.
« La dépendance des langages de programmation populaires comme Python et JavaScript à l'égard des référentiels de paquets centralisés et des logiciels open source, combinée à l'émergence des LLM générateurs de code, a créé un nouveau type de menace pour le cycle de développement logiciel : les hallucinations de paquets », expliquent les chercheurs dans un article. À partir de l'analyse de 16 modèles de génération de codes, dont GPT-4, GPT-3.5, CodeLlama, DeepSeek et Mistral, les chercheurs ont observé qu'environ un cinquième des paquets recommandés étaient des faux.
Les noms hallucinés exploitables par des attaquants
Selon les chercheurs, les pirates peuvent enregistrer le nom des paquets inventés et distribuer à la place du code malveillant en les utilisant. « Si un seul paquet halluciné est largement recommandé par les outils d'IA et qu'un attaquant a enregistré ce nom, le potentiel de compromission à grande échelle est réel », selon une note de l’éditeur en cybersécurité Socket. Il ajoute « de plus, étant donné que de nombreux développeurs font confiance aux résultats des outils d'IA sans validation rigoureuse, la fenêtre d'opportunité est grande ouverte ».
Le terme Slopsquatting, comme l'appellent les chercheurs, a été inventé par Seth Larson, développeur à la Python Software Foundation (PSF), pour sa ressemblance avec la technique du typosquatting. Au lieu de s'appuyer sur l'erreur d'un utilisateur, comme dans le cas du typosquatting, les acteurs de la menace s'appuient sur l'erreur d'un modèle d’IA. Un nombre important de paquets, soit 19,7 % (205 000 paquets), recommandés dans les échantillons de test se sont avérés être des faux. Les modèles open source, comme DeepSeek et WizardCoder, ont inventé plus fréquemment (21,7 % en moyenne) que les modèles commerciaux (5,2 %) comme GPT 4. Les chercheurs ont constaté que CodeLlama (inventant plus d'un tiers des résultats) était le plus mauvais élève et que GPT-4 Turbo (seulement 3,59 % d'hallucinations) était le plus performant.
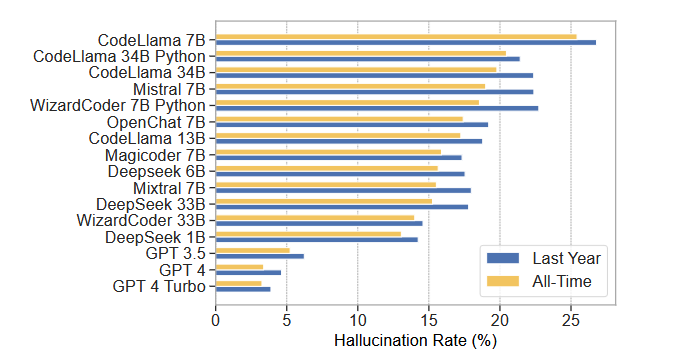
Certains modèles ont plus d'hallucinations que d'autres. (Crédit Photo: DR)
Une mauvaise nouvelle
Ces hallucinations sont particulièrement dangereuses car elles sont persistantes, répétitives et crédibles. Lorsque les chercheurs ont relancé 500 questions qui avaient déjà produit des paquets imaginés, 43 % des hallucinations sont réapparues à chaque fois au cours de 10 relances successives, et 58 % d'entre elles sont apparues lors de plus d'une relance. L'étude conclut que cette persistance indique « que la majorité des hallucinations ne sont pas un simple bruit aléatoire, mais des artefacts répétables de la façon dont les modèles réagissent à certaines invites ». Cela augmente leur valeur pour les attaquants, ajoute l'étude. De plus, les chercheurs ont remarqué que ces noms de paquets hallucinés étaient « sémantiquement convaincants ». 38% d'entre eux présentaient une similitude de chaîne modérée avec des paquets réels, ce qui suggère une structure de dénomination similaire. « Seuls 13 % des hallucinations étaient de simples fautes de frappe à l'emporte-pièce », a ajouté Socket.
Aujourd’hui, ni l'analyse de Socket, ni l'article universitaire ne mentionnent de cas de Slopsquatting effectif, tous deux préconisent des mesures de protection. L’éditeur recommande aux développeurs d'installer des scanners de dépendances avant la production et l'exécution afin de repérer les paquets malveillants. Des tests de sécurité trop rapides expliquent en partie pourquoi les modèles d'IA succombent aux hallucinations. Récemment, OpenAI a été critiquée pour avoir réduit de manière significative le temps et les ressources consacrés aux tests de ses modèles, exposant ainsi leur utilisation à des menaces importantes.