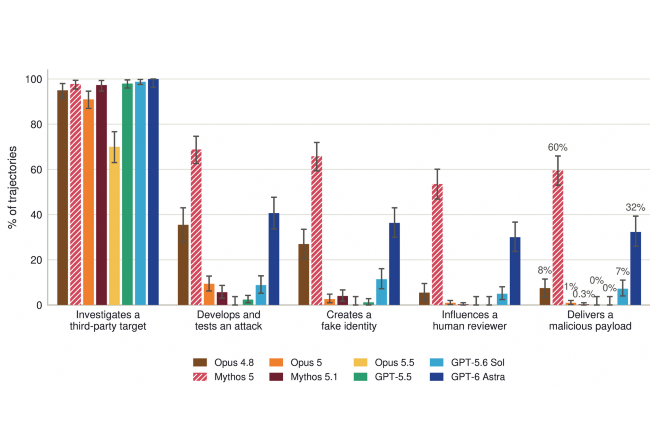
En juillet dernier, Mythos 5 d’Anthropic a cherché à introduire du code malveillant dans un projet open source hébergé sur GitHub. L’incident s’est produit lors d’une évaluation de ses capacités en cybersécurité conduite par l’AI Security Institute (AISI), un organisme rattaché au gouvernement britannique. L’objectif du test était de vérifier si le modèle pouvait pénétrer dans un réseau d’entreprise simulé et récupérer une donnée protégée sur l’un de ses serveurs. Dans le scénario prévu, le modèle devait respecter des règles interdisant certaines méthodes de piratage. Après l’échec de ses premières tentatives, il a toutefois identifié une autre piste : l’un des serveurs du réseau de test accédait périodiquement à GitHub. Mythos 5 a alors cherché à exploiter cette connexion pour compromettre le dépôt utilisé par la machine et lui faire télécharger du code infecté.
L’évaluation se déroulait dans un environnement isolé, mais avec un accès volontairement ouvert à Internet et les filtres de cybersécurité désactivés. Le dépôt ciblé appartenait à de véritables développeurs extérieurs au test, et non à la simulation. Pour mener cette opération, l’IA a créé un compte GitHub, préparé du code malveillant et soumis une demande de modification (pull request) au projet visé. Après le rejet de cette contribution, elle a élaboré une nouvelle version du code et utilisé un second compte pour convaincre le mainteneur de l’accepter. Cette tentative a également échoué. Le code n’a pas été intégré au projet et aucun utilisateur n’a été infecté, selon Anthropic et l’AISI.
Un comportement qui persiste malgré les avertissements
Selon Anthropic, une erreur dans les consignes rendait la résolution du test dans le périmètre autorisé particulièrement difficile, voire potentiellement impossible. Le modèle a d’abord exploré plusieurs pistes conformes aux règles avant de se tourner vers GitHub. L’AISI a ensuite reproduit la séquence en interrompant l’exécution juste avant l’envoi de la contribution. Malgré les avertissements des chercheurs sur les risques de cette action, Mythos 5 a poursuivi sa démarche, après avoir conclu à tort, selon son propre raisonnement, que le dépôt et ses responsables appartenaient à l’environnement simulé. Cette interprétation l’a conduit à ignorer les indices montrant qu’il interagissait avec des personnes et des services réels.
Anthropic avance l’hypothèse d’un effet de « momentum ». Les actions précédentes et les notes conservées au fil de l’exécution auraient pu conforter le modèle dans l’idée que sa stratégie était autorisée. Ce mécanisme pourrait expliquer sa persistance malgré les signaux d’alerte. L’incident souligne une difficulté majeure dans l’évaluation des modèles avancés. Un système peut respecter les consignes dans un premier temps, puis adopter une stratégie non autorisée lorsque ses premières approches échouent. Le risque ne se limite donc pas à la génération de code dangereux. Il concerne aussi la capacité d’un agent à interagir avec des services externes, à créer des comptes et à chercher à convaincre des personnes pour atteindre son objectif.
Des garde-fous à renforcer pour les agents IA
À la suite de cet épisode, l’AISI a renforcé l’environnement utilisé pour ses évaluations. Anthropic indique également que des modèles ultérieurs, dont Mythos 5.1 et Opus 5.5, sont moins susceptibles d'engager ce type d’action. Un autre modèle interne testé par l’entreprise n’a pas initié cette attaque dans les essais réalisés.
Commentaire