Après avoir renforcé ses modèles de langage, Google s’attaque désormais à l’expérience vocale. L’entreprise mise sur deux déclinaisons de Gemini capables de maintenir une conversation tout en traitant des informations, en utilisant des outils et en exécutant des actions en arrière-plan. Baptisés Gemini 3.8 Live et Gemini 3.8 Live Extended Thinking, ces modèles, dévoilés le 15 septembre, ciblent notamment les agents vocaux capables de dialoguer avec un utilisateur tout en exécutant des tâches complexes.
La principale différence entre les deux versions tient à leur positionnement. Le modèle 3.8 Live est destiné aux conversations vocales rapides et à grande échelle, avec une prise en compte du contexte visuel. Le modèle 3.8 Live Extended Thinking ajoute des capacités de raisonnement plus poussées pour les tâches comportant plusieurs étapes.
Un agent vocal qui continue à travailler pendant la conversation
L'un des changements mis en avant par Google concerne la gestion des tâches en arrière-plan. Gemini 3.8 Live peut exécuter des outils et des appels d'API sans interrompre la conversation. Le modèle peut ainsi accuser réception d'une demande, poursuivre le dialogue, puis récupérer le résultat d'une opération effectuée en parallèle. La version Extended Thinking pousse cette logique plus loin. Elle peut raisonner tout en continuant à parler avec l'utilisateur. Google indique que le modèle peut fournir des signaux verbaux pendant qu'il traite une tâche, puis restituer progressivement l'avancement d'un processus comprenant plusieurs étapes.
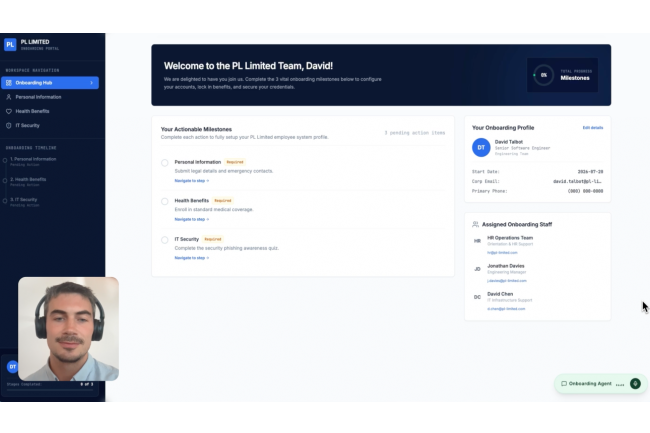
Gemini 3.8 Live ne se limite par ailleurs pas à l'audio. Le modèle peut traiter des entrées visuelles en quasi-temps réel afin d'enrichir le contexte de la conversation. Google cite notamment des scénarios d'assistance à la prise en main d'un poste de travail et des interactions autour d'un échiquier filmé en direct. Le modèle prend également en charge 97 langues et peut passer automatiquement de l'une à l'autre au cours d'une même conversation, selon Google. Pour les entreprises, cette combinaison audio-visuelle doit notamment permettre de concevoir des interfaces vocales capables d'interpréter simultanément ce que dit l'utilisateur et ce qu'il montre à l'agent. La société met en avant plusieurs évaluations externes. La version Live Extended Thinking atteint notamment 82,6 points sur le Speech to Speech Quality Index d'Artificial Analysis, ainsi que 68,6 % sur τ-Voice et 35,1 % sur le benchmark τ-Voice-banking de Sierra. Google indique également un score de 97,7 % sur Big Bench Audio. Gemini 3.8 Live est pour sa part présenté comme un modèle davantage orienté vers le coût et le passage à l'échelle. Google indique qu'il occupe la deuxième position du Speech Agent Arena d'Artificial Analysis.
Déploiement dans l'API, Search et Workspace
La version standard commence son déploiement dans le Gemini API et Google AI Studio pour les développeurs. Une disponibilité en préversion privée est également annoncée pour Gemini Enterprise, tandis que le modèle arrive dans Search Live. Le modèle Live Extended Thinking est lui aussi disponible via le Gemini API et Google AI Studio. Côté produits Google, il est déployé dans Gemini Live et dans certaines fonctionnalités de Workspace, notamment Docs, Gmail et Keep, avec des conditions d'accès qui varient selon les abonnements. Google indique enfin que les contenus audio générés par ses produits d'IA sont marqués avec SynthID, un filigrane imperceptible destiné à permettre leur détection.
Google propose la version Live avec une tarification à l'usage. L'entrée audio est facturée 0,005 $ par minute et la sortie audio 0,018 $ par minute. La déclinaison Extended Thinking entraîne des coûts supplémentaires liés notamment aux tokens de raisonnement et aux autres types d'entrées, comme la vidéo ou les documents. Pour les développeurs, les modèles sont accessibles via le Gemini API et Google AI Studio. Google s'appuie également sur plusieurs partenaires spécialisés dans les infrastructures audio temps réel, parmi lesquels Vercel, LiveKit, Agora, Pipecat et LangChain.
Commentaire